流水线 NTT 多项式模乘架构论文精读
拆解 Serial、Serial Fold、2-parallel 与 4-parallel 四种流水线 NTT 多项式模乘架构,重点理解交错折叠、DSD 数据交换与吞吐率—面积权衡。
论文把 LC-NTT/LC-INTT、R2MDC 流水线与层级交错折叠组合成四档并行度的多项式模乘器:Serial Fold 用约一半 BFU 换取满利用率,4-parallel 则用更多面积换最低稳态周期。
1. 论文概述#
【Paper】 这篇论文研究的是一个可独立复用的 NTT-based polynomial modular multiplier:输入两条长度为 的多项式,先分别做 NTT,再逐点相乘,最后做一次 LC-INTT,得到 。作者没有把问题包装成完整的 Kyber、Dilithium 或同态加密处理器,而是把资源、流水线和吞吐率集中在这条最核心的多项式乘法数据流上。[1] p. 2474–2476, Abstract and Sections I–II
一句话总结#
【Paper】 论文的核心不是发明新的 NTT,而是把“输入速率受限的 R2MDC 数据流”重新安排:Serial 作为面积基线,Serial Fold 用层级交错折叠填满 LC-INTT 的空闲 BFU,2-parallel 和 4-parallel 则复制并行流水线以换取更高吞吐。[1] p. 2476–2479, Sections II–III
核心贡献#
【Paper】
- 四档并行度的统一架构族。 Serial、Serial Fold、2-parallel 与 4-parallel 都使用 pipelined LC-NTT/LC-INTT 和 R2MDC 风格的 BFU/DSD 结构,因此可以在同一组资源计数公式下比较。
- Serial Fold。 通过 hierarchical interleaved folding,把原本需要连续等待输入的 LC-INTT 蝶形阶段映射到约一半的物理 BFU 上;论文将其定位为首个 100% BFU utilization 的 serial R2MDC NTT-based polynomial multiplier。
- 并行 folding 的调度。 2-parallel 与 4-parallel 使用 ASAP folding sets,将多条 NTT/INTT 流尽早合并,以减少 commutator 和流水线等待。
- 可量化的设计空间。 论文同时给出 BFU、DSD delay、pipeline cutset、PWM 数量,以及 和 时的频率、延迟、BPP、功耗、面积和 throughput/area。[1] p. 2476–2479 and 2483–2486, Sections III–V, Tables II–IV
2. 背景与相关工作#
【Paper】 设 ,。朴素多项式乘法需要 次系数乘法;NTT 把它变成两个 的变换、 次逐点乘法和一个逆变换。对硬件而言,挑战不是渐近复杂度,而是如何让蝶形单元在连续输入、非连续 twiddle factor 和负 wrapped convolution 的约束下保持高利用率。[1] p. 2474–2477, Sections I–II
论文采用 low-complexity NTT/INTT(LC-NTT/LC-INTT):把 weighted preprocessing/postprocessing 合并到蝶形,避免为每个系数另放一组权重乘法。NTT 使用 DIT,INTT 使用 DIF;INTT 的输出还要处理 因子,最终得到 缩放后的系数。[1] p. 2475–2478, Algorithms 1–2 and Figures 2–4
【Analysis】 论文的真正切入点是“流式 NTT 的供给速率和消费速率不匹配”。R2MDC 蝶形通常希望两个输入同时到达,但 serial 输入每拍只有一个系数;如果直接套用 conventional serial R2MDC,PE 一半时间在等另一条数据。于是本文的关键问题可以重写为:在不把所有 BFU 都复制一遍的前提下,能否用 folding 和 delay network 把已有输入重新编排成两路有效流?
3. 问题定义#
【Paper】 目标运算为
其中 ,系数表示为 。NTT-domain 数据流可以概括为
实验固定 。它是 32-bit、只有 4 个非零 bit 的模数,因此 Barrett reduction 可以部分映射到 shift-and-add unit(SAU);twiddle factor 放在 LUT 中,整个实现是 compile-time constant(CTC),不是 run-time configurable(RTC)。[1] p. 2477–2478, Sections II–III, Figures 2–4
本文需要区分三个边界:
- 计算边界: 覆盖两次 NTT、一次逐点模乘和一次 INTT,不覆盖协议级采样、压缩、解压或密钥调度。
- 评估边界: Table III 的 latency 是首个输入到首个输出;BPP 是首个输出之后连续生成 个输出所需的周期,不应把两者混成单个 latency。
- 实现边界: 结果来自 Virtex-7 VC709 的 post-route 结果,面积是作者定义的等效面积 。[1] p. 2484–2486, Section V and Tables III–IV
4. 方法#
4.1 四种架构的共同骨架#
【Paper】 四种设计共享同一条宏观路径:输入系数经过两个 LC-NTT,进入一个或多个 polynomial-wise multiplier(PWM),然后进入 LC-INTT。差别集中在 NTT/INTT 流的复制数、BFU 数量以及 DSD 如何把单路或多路输入重新配对。
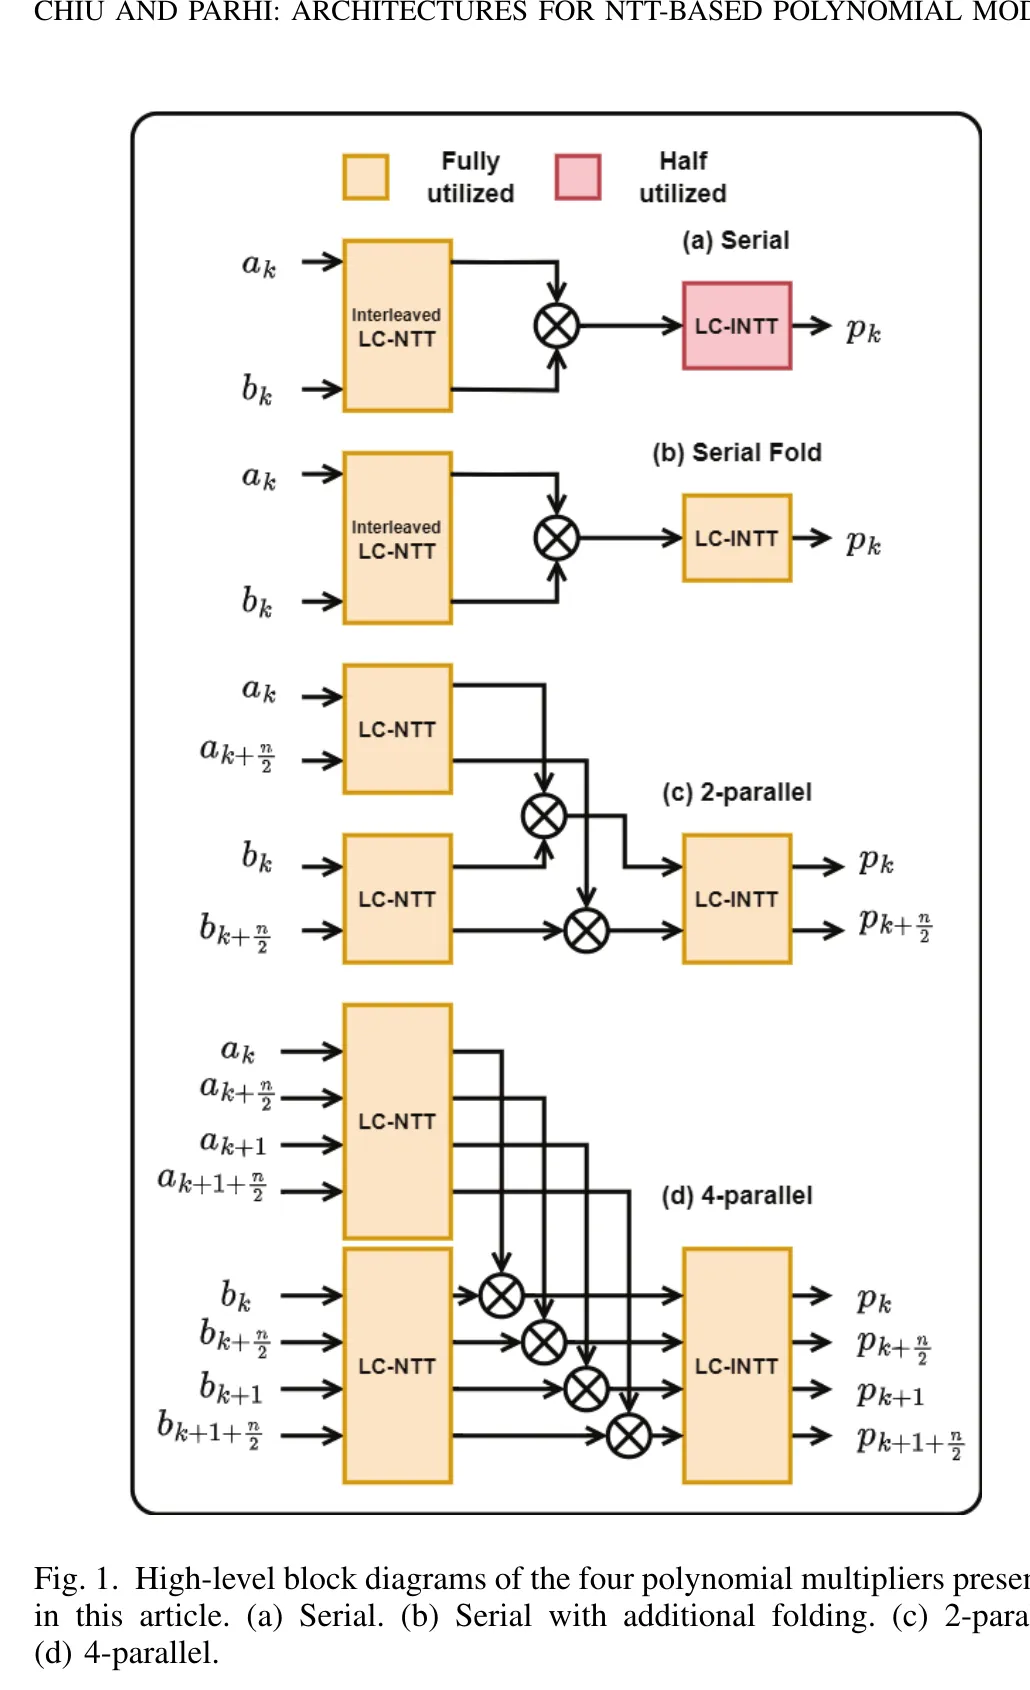
图中的四条路线可以这样读:
| 架构 | NTT/INTT 流 | PWM | 设计目标 |
|---|---|---|---|
| Serial | 两路 NTT 输入 + 一路 INTT 输出 | 1 | 最低复制度的面积基线 |
| Serial Fold | serial NTT + 折叠后的 serial LC-INTT | 1 | 在近似 serial 面积下消除 INTT 空转 |
| 2-parallel | 两条并行数据流 | 2 | 以中等复制度降低 BPP |
| 4-parallel | 四条并行数据流 | 4 | 最大化稳态吞吐 |
【Analysis】 因此“serial”并不等于“低延迟”:它只意味着每拍的外部系数供给较少。端到端首个输出还要穿过 个蝶形级和 级 delay network;Serial Fold 的价值主要体现在资源利用率与能耗,而不是缩短第一颗结果出现的时间。
4.2 核心机制:交错折叠填补 R2MDC 空闲槽#
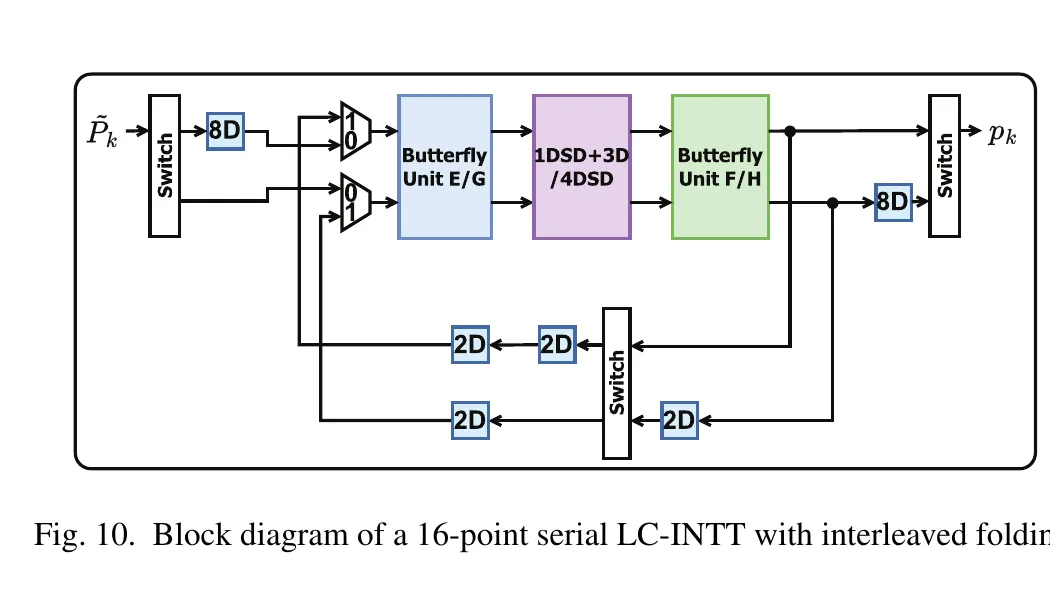
【Paper】 conventional serial R2MDC PE 需要两个输入,而 serial 端口每拍只给一个输入,直接使用会产生 50% utilization。作者先用 interleaved input 把 、 两个 NTT 输入交织起来,再将 LC-INTT 的蝶形分成 folding sets,使不同阶段的部分数据在空闲周期进入同一 BFU。Serial Fold 的两个关键 folding set 是 E/G 和 F/H;它们在数据依赖允许的时刻复用物理 BFU,同时用 DSD 和 feedback delay 保持正确顺序。[1] p. 2478–2483, Sections III–IV and Figures 8–13
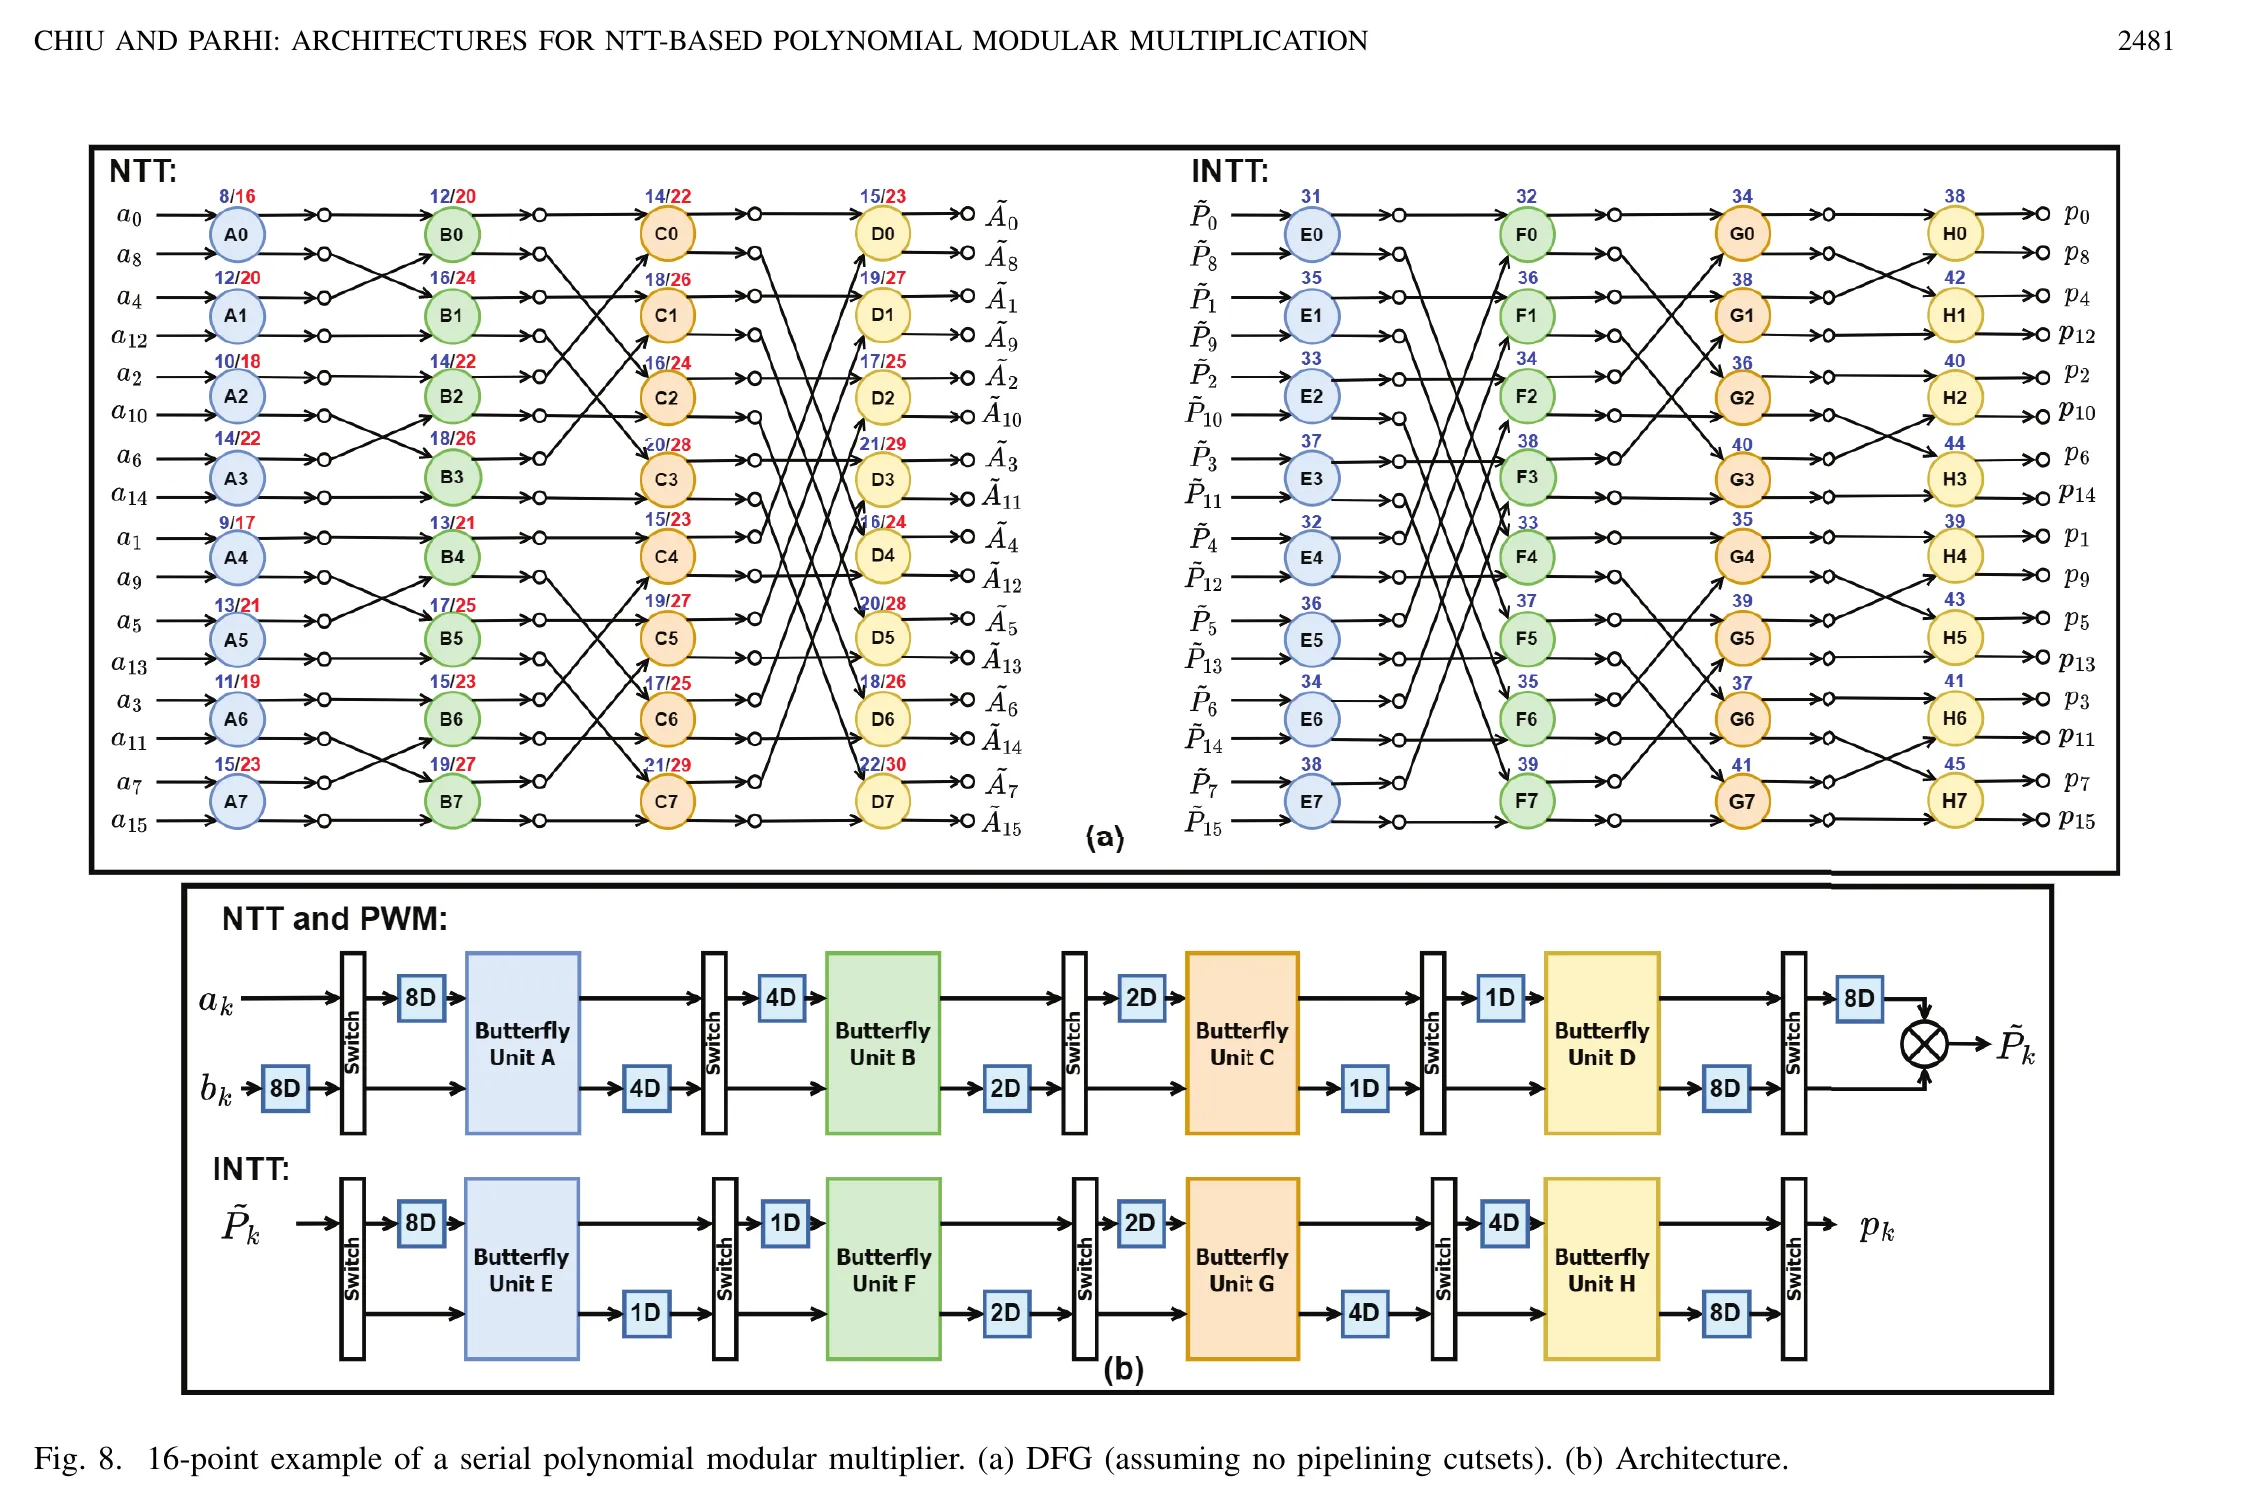
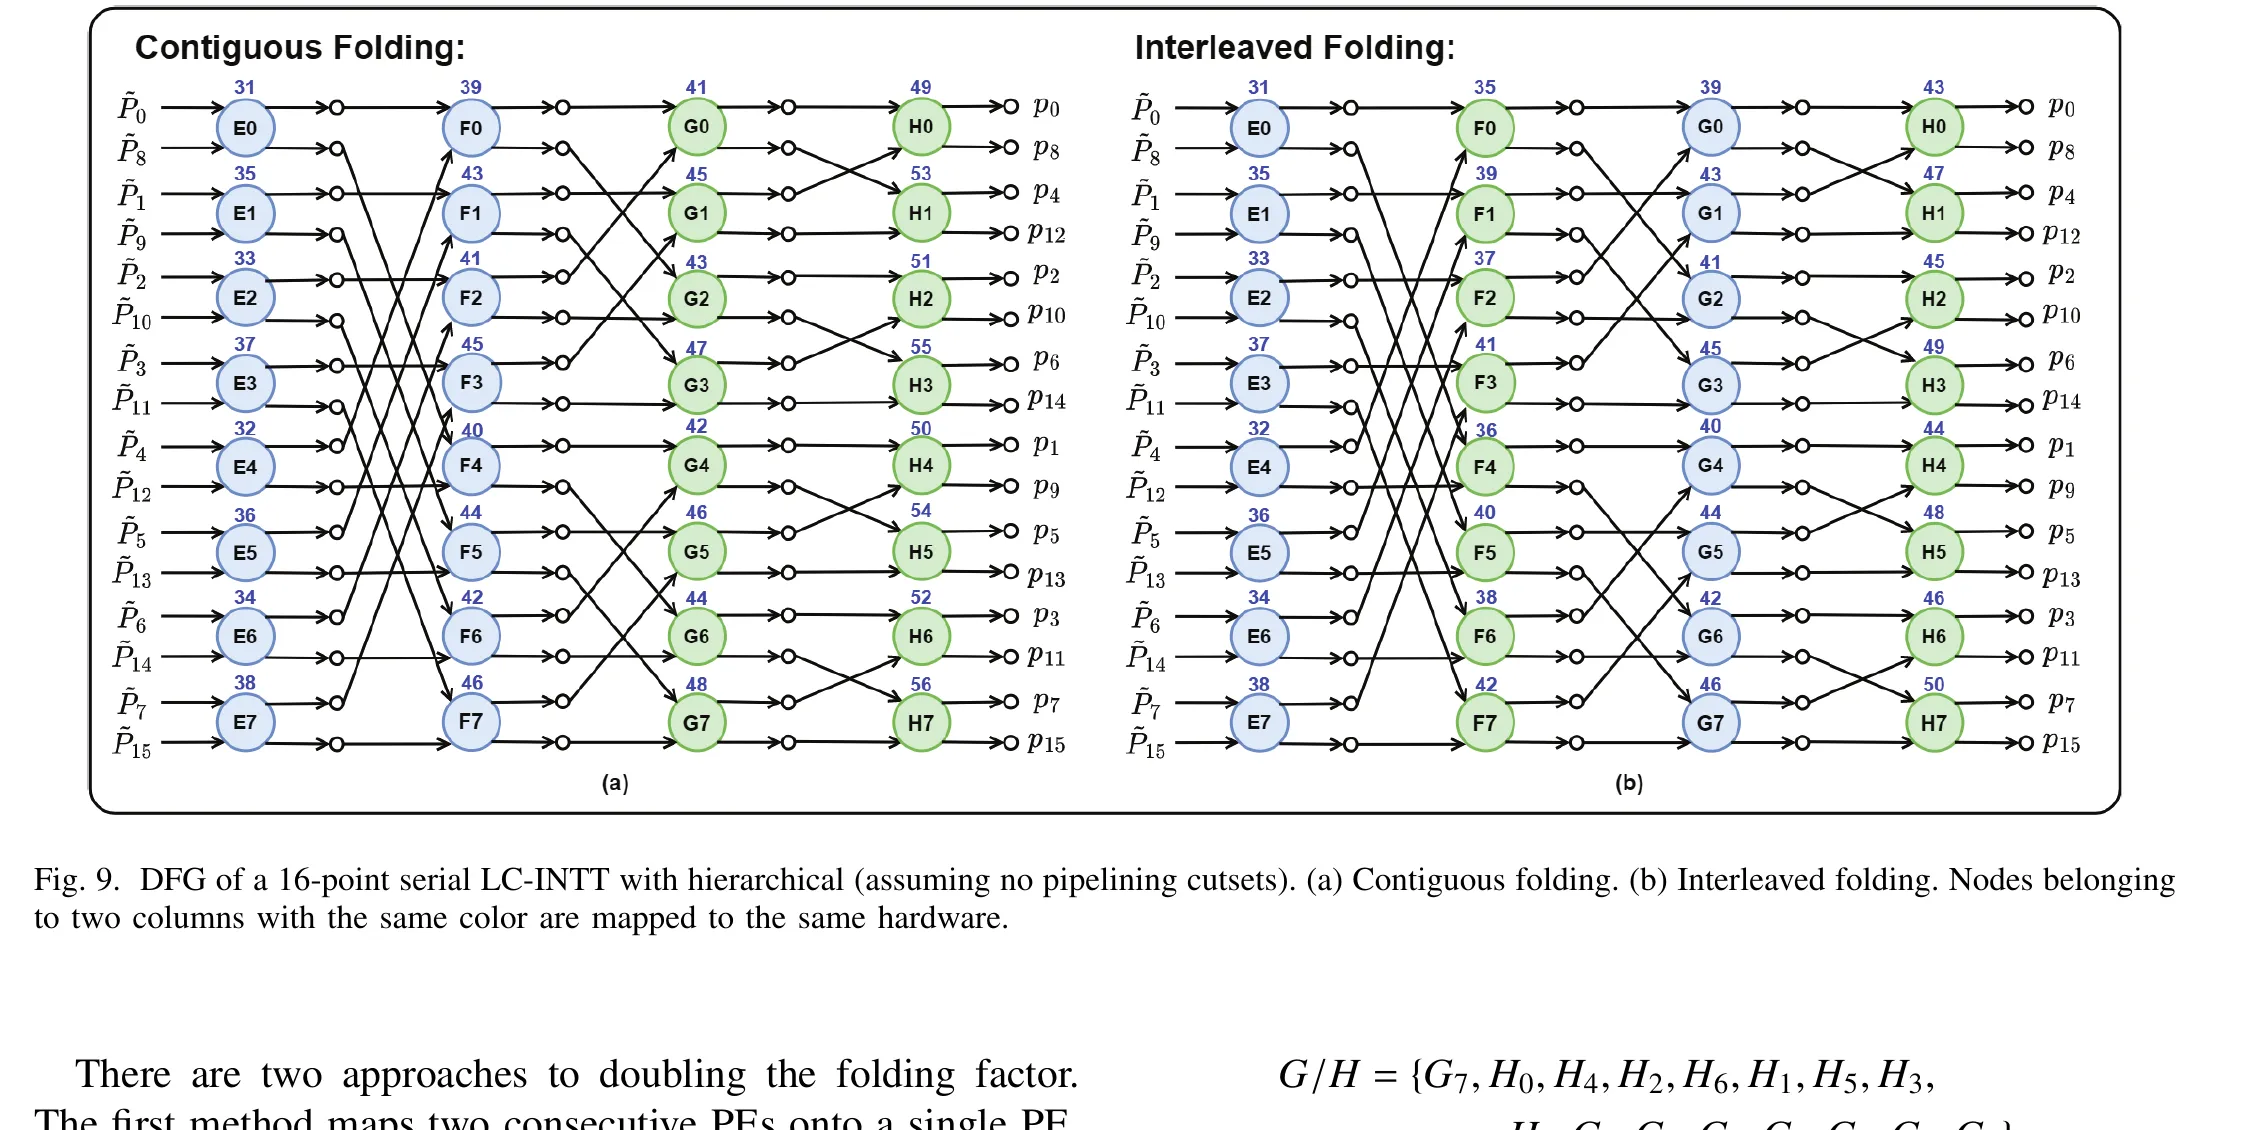
折叠不是简单地把图画“压扁”。它必须同时满足三类约束:
- 依赖约束: 被合并的两个蝶形不能在同一时刻需要同一份尚未产生的输出。
- 顺序约束: feedback loop 的总 delay 必须正好等于 ,否则下一轮数据会提前或滞后进入 BFU。
- 流水约束: retiming 要把寄存器放进 cutset,并尽量复用原本已经存在的 delay element。
4.3 算术与数据通路#
【Paper】 论文的算术单元由 Barrett modular multiplication、SAU、LC-NTT/LC-INTT BFU、twiddle LUT、DSD 和 PWM 组成。Barrett 用 把除法替换成乘法与移位;在给定 的低汉明重量结构下,SAU 进一步把常数乘法拆成移位加法与条件减法。LC-INTT 的 因子被并入蝶形路径,避免独立的 scaling multiplier。[1] p. 2477–2479, Figures 2–5 and Algorithms 1–2
| 单元 | 作用 | 对架构的影响 |
|---|---|---|
| LC-NTT BFU | DIT 蝶形、twiddle 乘法与加减 | 两条 serial 输入流各需要 个 BFU 级 |
| LC-INTT BFU | DIF 蝶形、逆 twiddle、 融合 | Serial 原始结构只有半利用率,是折叠优化的主要目标 |
| Barrett + SAU | 固定模数的乘法、移位和条件修正 | CTC 设计降低可配置性,但可利用 的 bit pattern |
| DSD | delay、switch、delay 的组合 | 改变数据配对与顺序,不承担模运算 |
| PWM | NTT 域逐点乘法 | 并行度为 时复制 个 PWM |
4.4 资源、存储与调度公式#
【Paper】 Table II 把架构族的规模写成 -parallel 的统一形式。令 为每个 BFU 的 pipeline cutset 数,PWM 使用 个 cutset,则:
| Design | BFUs | DSD 中 delay elements | pipeline elements | PWMs |
|---|---|---|---|---|
| Serial | 1 | |||
| Serial Fold | 1 | |||
| 2-parallel | 2 | |||
| 4-parallel | 4 | |||
| -parallel |
DSD 的优化也很具体:如果一条路径由 个 DSD 和 个 delay 组成,另一条路径由 个 DSD 组成,合并后可以从 pre-optimization 的 个 mux、 个 demux 和 个 delay,变成 个 mux 和 个 delay。[1] p. 2482–2484, Section IV, Figures 11–13 and Table II
5. 实验#
5.1 实验设置#
【Paper】 所有 proposed designs 使用同一个 32-bit 模数 ,目标器件为 Xilinx Virtex-7 VC709,频率和资源来自实现后的结果。 与 两组结果都覆盖四种架构;Serial Fold 的流水级数按 Table I 的 retiming 结果处理。[1] p. 2483–2485, Section V and Tables I–IV
本文按作者的定义保留三个容易混淆的量:
- Latency: 输入第一颗系数到输出第一颗系数的周期数。
- BPP: steady-state 每完成一个 length- polynomial multiplication 所需周期数。
- Energy: ;所以 BPP 降低和频率升高都会影响能耗。
5.2 性能、延迟、功耗与能耗#
【Paper】 Table III 的 proposed 结果如下;这些数字是论文报告值,不是用四舍五入后的频率重新推导的值。
| Design | Freq. (MHz) | Latency (CC) | BPP (CC) | Power (W) | Energy (µJ/PolyMult) | Energy-BPP (pJ) | |
|---|---|---|---|---|---|---|---|
| 1024 | Serial | 279 | 2662 | 1024 | 1.73 | 6.35 | 23.33 |
| 1024 | Serial Fold | 284 | 3087 | 1024 | 1.49 | 5.35 | 19.29 |
| 1024 | 2-parallel | 292 | 1126 | 512 | 2.39 | 4.20 | 7.37 |
| 1024 | 4-parallel | 301 | 614 | 256 | 4.75 | 4.04 | 3.43 |
| 4096 | Serial | 281 | 10362 | 4096 | 2.68 | 39.09 | 570.05 |
| 4096 | Serial Fold | 281 | 12317 | 4096 | 2.38 | 34.73 | 506.48 |
| 4096 | 2-parallel | 292 | 6266 | 2048 | 3.16 | 22.17 | 155.73 |
| 4096 | 4-parallel | 301 | 3194 | 1024 | 3.01 | 24.82 | 84.37 |
这里最值得注意的是 的 4-parallel:它的功耗只有 3.01 W,低于 的 4.75 W,但因为多项式长度增长了四倍,单次 PolyMult 能耗仍从 4.04 µJ 上升到 24.82 µJ。不要把瞬时功耗和单次运算能耗当成同一个指标。
5.3 资源与效率#
【Paper】 Table IV 给出的 proposed 资源和效率如下。TP 是每秒完成的 length- polynomial multiplication 数,TP/area 使用论文的等效面积定义。
| Design | LUT | FF | DSP | Area | TP (PolyMult/s) | TP/area | TP²/area | |
|---|---|---|---|---|---|---|---|---|
| 1024 | Serial | 23032 | 7749 | 84 | 15127 | 272023 | 17.983 | 4890K |
| 1024 | Serial Fold | 20068 | 6688 | 64 | 12253 | 277433 | 22.642 | 6282K |
| 1024 | 2-parallel | 29542 | 10597 | 128 | 21510 | 569424 | 26.472 | 15074K |
| 1024 | 4-parallel | 53769 | 20130 | 256 | 41559 | 1176581 | 28.311 | 33311K |
| 4096 | Serial | 48156 | 10846 | 100 | 23395 | 68579 | 2.931 | 201K |
| 4096 | Serial Fold | 44521 | 9601 | 76 | 19930 | 68579 | 3.441 | 236K |
| 4096 | 2-parallel | 53117 | 13719 | 152 | 30194 | 142356 | 4.715 | 671K |
| 4096 | 4-parallel | 91942 | 28443 | 304 | 56491 | 294145 | 5.207 | 1532K |
从 看,Serial Fold 的 area 比 Serial 小约 19%,TP 还略高;这正是折叠消除空转的直接结果。4-parallel 的面积约为 Serial Fold 的 3.39 倍,但 TP 约为 4.24 倍,所以 TP/area 仍然从 22.642 提升到 28.311。 时四档设计的面积和 TP 都增长,但 Serial Fold 仍以最小面积取得比 Serial 更好的 TP/area。
5.4 设计空间的实际选择#
【Analysis】 可以把四种架构看作一条连续的工程旋钮,而不是四个互不相关的实现:
| 约束优先级 | 更合适的选择 | 原因 |
|---|---|---|
| DSP/LUT 紧张、吞吐要求不高 | Serial Fold | 用少量 BFU 复用换取完整的 LC-INTT 利用率 |
| 需要折中吞吐与面积 | 2-parallel | BPP 约减半,资源增量仍低于 4-parallel |
| 追求单引擎最高稳态吞吐 | 4-parallel | BPP 最低,TP/area 在本文四档中最高 |
| 需要极简基线或便于验证 | Serial | 结构最直观,但 INTT 空闲槽不能忽略 |
论文对已有工作也报告了相对提升:Serial Fold 的 TP/area 相对 state-of-the-art 至少约为 ()和 ();4-parallel 分别至少约为 和 。TP/area 的差距更大,因为该指标进一步奖励 throughput。[1] p. 2485–2486, Table IV and discussion in Section V
6. 方法分析#
6.1 为什么有效?#
【Analysis】 这篇论文最有价值的抽象是:当数据流的外部注入速率低于 BFU 的消费需求时,优先重排时间与数据顺序,再考虑复制算术单元。Serial Fold 的面积收益并不是来自更快的模乘,也不是来自减少 NTT 层数,而是来自把“等待另一输入”的空闲槽变成另一 folding set 的计算槽。
这解释了三个结果同时成立的原因:
- Serial Fold 比 Serial 多一点首个输出等待,但 BFU 数量从 降到约 。
- 2-parallel 和 4-parallel 几乎按并行度降低 BPP,但 LUT、FF、DSP 和 DSD 也随复制度快速增加。
- 4-parallel 的 TP/area 仍然最高,说明在作者的 Virtex-7 和固定 条件下,流水线填充收益超过了复制成本。
6.2 核心创新#
【Paper】 创新主要落在微架构组织而非 NTT 算法本身:
- 把 serial R2MDC 的利用率问题明确化,并用 interleaved folding 给出可扩展到 的组织方式。
- 用 ASAP folding sets 处理 2-parallel/4-parallel 的多流配对,避免并行复制后又被 DSD 重新串行化。
- 通过 DSD sharing、feedback-loop delay 和 retiming,把正确的时序约束落成可计数的 delay elements 与 cutsets。
- 用表格把 BFU、DSD、pipeline 和 PWM 的数量统一为参数化表达式,便于做 area/throughput 预算。[1] p. 2478–2484, Sections III–IV and Table II
6.3 与已有方法的本质区别#
【Analysis】 论文的比较有参考价值,但不应直接解读为“任何平台上都更好”。至少有四个条件需要同步记录:
| 比较维度 | 本文设定 | 可能改变结论的因素 |
|---|---|---|
| 模数 | 固定 32-bit、低汉明重量 | 任意模数或更宽模数会削弱 SAU 优势 |
| 器件 | Virtex-7 VC709 | DSP 数量、BRAM 端口和 routing topology 不同会改变折叠收益 |
| 输入输出 | standalone polynomial multiplier | 协议级 DMA、缓存和 NTT-domain reuse 会改变端到端占比 |
| 指标 | TP、area、power、energy-BPP | 不同工作负载下吞吐与能耗权重可能不同 |
尤其是,如果上游已经把一个输入留在 NTT domain,完整乘法可以省掉一次 NTT;如果多项式乘法被批处理,BPP 可能比首个输出 latency 更重要。论文也指出,HE/PQC 场景中的这种 NTT-domain reuse 会改变架构映射。[1] p. 2485–2487, Sections V–VI
6.4 代价与适用条件#
【Analysis】 第一,CTC 模数让 SAU 和 twiddle LUT 很高效,却牺牲了对不同参数集的复用;把它搬到 Kyber、Dilithium、CKKS 等不同模数体系,不能只替换一个常数表。第二,Serial Fold 的 folding correctness 依赖完整的 schedule、feedback 和 retiming 证明,验证复杂度高于直连的 parallel pipeline。第三,4-parallel 的高 TP 伴随显著的 DSP/LUT 复制,若系统瓶颈在内存或片上互连而非算术,复制可能无法线性换来端到端加速。
7. 局限性#
7.1 作者明确提出的局限#
【Paper】 作者指出,若模数位宽进一步增大,可以考虑 residue number system(RNS)分解;在 BFV、BGV、CKKS 等应用中,若某个输入已经处于 NTT domain,可以移除一个 NTT;Serial Fold 也可以复用于 NTT/INTT 本身。论文将 BFV/BGV/CKKS 的更完整映射留作未来工作。[1] p. 2486–2487, Section VI
本文没有做官方 RTL/HDL 代码级对照:Zotero 中的本地全文包含论文与图表,但作者未在论文中给出可核验的官方代码仓库。因此本文对算法和架构的复述以正文、算法、图、表为证据边界,不把本文重建的伪代码冒充作者 RTL。
7.2 自己分析得到的局限#
【Analysis】
- 论文把 100% utilization 作为 Serial Fold 的核心卖点,但 Table III/IV 主要给出综合后的周期、资源和吞吐结果;若要验证 utilization 本身,需要 RTL simulation 的 stage occupancy 或 cycle-by-cycle trace。
- 表中面积是作者定义的加权等效面积,不是某一平台的物理 die area;跨论文比较时必须保留权重公式。
- 论文没有把 side-channel leakage、fault tolerance、时序常数性或协议级安全边界作为实验主题;本文也不应从“固定模数 + 流水线”推出安全性结论。
- 若移植到 runtime-configurable modulus,必须重新检查 Barrett 常数、SAU 位宽、twiddle 生成和 range proof,不能只把 做成寄存器输入。
8. 启发与研究思考#
【Analysis】 基于论文的架构—指标关系,我会优先验证以下三个方向:
- 自适应 folding。 当 、批处理深度和输入注入速率变化时,选择不同 folding set,是否能在不复制完整 BFU 的情况下逼近 2-parallel 的 BPP?关键实验是比较 occupancy、DSD delay 与 energy-BPP,而不只看频率。
- CTC/RTC 混合模数。 保留固定宽度的 SAU datapath,只把少数 Barrett/twiddle 参数改成可配置,是否能在可复用性和面积之间得到比完全 RTC 更好的折中?
- 协议级 NTT-domain reuse。 在 Kyber/ML-DSA 或 CKKS 的真实乘法批次中,省掉一次 NTT 后,Serial Fold 与 4-parallel 的最优点是否仍然和 standalone PolyMult 一致?这需要把 DMA、缓存和多项式批处理一起纳入测量。
【Paper】 本文的数字、公式、架构名称和图表定位均来自论文正文、Algorithms 1–2、Figures 1–13、Tables I–IV;本地全文副本来自 Zotero,并保存在文章的内部 paper record 中。[1] p. 2474–2487, full text
参考资料
- Sin-Wei Chiu and Keshab K. Parhi. Architectures for Serial and Parallel Pipelined NTT-Based Polynomial Modular Multiplication. 2025. IEEE Transactions on Very Large Scale Integration (VLSI) Systems 原文