HQC 论文精读:统一采样、共享存储与细粒度重叠调度
拆解 HQC 硬件加速器的统一并行采样模块、四路稀疏乘法器、共享寄存器库和细粒度重叠执行,并核对 FPGA、ASIC 与官方 RTL 之间的边界。
这篇论文把 HQC 中两种采样模式合并到一个四路 PSM,把稀疏-稠密乘法压进共享寄存器库驱动的 PPAM,再用细粒度重叠执行把采样和乘法流水化;收益来自减少重复硬件与等待,而不是某一个孤立算术单元的加速。
1. 论文概述#
【Paper】
HQC 是基于码的后量子 KEM。它的硬件实现同时面对三类不太友好的工作:稀疏向量与稠密多项式相乘、从伪随机流中采样不重复的索引,以及 KeyGen、Encaps、Decaps 之间大量可复用但时序不同的中间数据。论文的核心问题不是“怎样把一个乘法器做得更快”,而是怎样让采样、稀疏乘法和存储访问尽量共享资源,并且让它们在同一个执行窗口内重叠起来。
作者在 Artix-7 FPGA 上实现了三层设计:统一并行采样模块(PSM)、统一四路并行多项式乘法器(PPAM),以及细粒度重叠执行方案(FGOES)。论文还给出了 110 nm CMOS 的综合面积与功耗估算,但没有给出流片后的硅测量。[1] pp. 1-3, Abstract
一句话总结#
【Paper】
用一个可切换的四路采样器服务 CWW/FNB,用一个共享寄存器库服务四路稀疏乘法,再用数据到达即启动的调度把三种 HQC 操作重叠起来,以较少 BRAM 换取更高的系统级利用率。[1] pp. 4-10, Figs. 1-11
核心贡献#
【Paper】
- PSM 统一支持固定重量采样(CWW)和固定非零采样(FNB),以 4 路候选生成和重复检测降低采样等待。
- PPAM 用一个共享寄存器库驱动四个移位器,统一稀疏-稠密乘法的数据通路,减少为每一路复制的稠密多项式存储。
- FGOES 让 PSM 产生的索引批次直接触发 PPAM,避免“采样全部结束后才开始乘法”的串行空洞。
- FPGA 结果覆盖 HQC-1、HQC-3、HQC-5,另给出 110 nm 工艺下的面积、功耗和三种工艺角估算。[1] pp. 4-13, Tables I-V
2. 背景与相关工作#
【Paper】
HQC 在环 上工作,核心硬件操作是按稀疏位置对稠密多项式做移位并 XOR。相比规则的定长乘法,它的访问地址取决于采样到的索引;相比普通随机数采样,HQC 还需要满足重量、范围、不重复等条件。HQC-1、HQC-3、HQC-5 的 分别为 17669、35851、57637,参数越大,存储深度和扫描代价越明显。[1] pp. 3-4, Section III-A
已有工作通常分别优化采样器、稀疏乘法器或某一个 KEM 阶段。论文认为这种拆分会带来三种浪费:CWW 和 FNB 各自保留一套采样逻辑;四路乘法器各自维护稠密数据副本;采样和乘法之间用完整批次作为同步边界,导致计算单元等待。本文的技术定位,是把“相同的数据变换”提取成统一模块,再把同步边界从整段任务缩小到索引批次。[1] pp. 2-4, Table I
【Analysis】 这里的统一并不等于完全无参数。PSM 统一的是候选生成、模约减、重复检查和有效性提交的骨架;CWW 的全扫描语义、FNB 的范围检查,以及不同 和 仍然改变控制路径。PPAM 也只共享稠密数据访问与移位逻辑,累加 RAM、边界处理和控制状态仍然需要按实现参数配置。
3. 问题定义#
【Paper】
对稀疏多项式 和稠密多项式 ,目标是计算
硬件输入不是一串已经排好序的索引,而是由 SHAKE/Keccak 伪随机流产生的候选值。PSM 必须输出满足如下条件的索引集合:数量为目标重量 ,索引在 内,且没有重复。CWW 采样还要求相应的符号/比特信息;FNB 则只需要得到固定重量的非零位置。[1] pp. 3-5, Sections III-A and III-B
| 维度 | 本文实现边界 |
|---|---|
| 密码运算 | HQC KeyGen、Encaps、Decaps 的硬件数据通路 |
| 采样模式 | CWW 与 FNB,共享一个 PSM |
| 并行度 | PSM 四路候选;PPAM 四路索引/移位处理 |
| FPGA 参数 | HQC-1:、;HQC-3:、;HQC-5:、 |
| ASIC 结果 | 110 nm、目标频率 200 MHz 的综合估算 |
| 不应过度解读 | 论文没有流片测量、侧信道评估或端到端软件吞吐基准 |
4. 方法#
4.1 Overall Architecture#
【Paper】
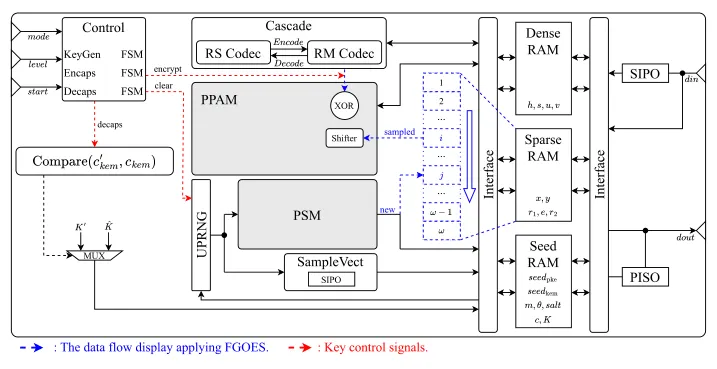
原文 Fig. 1,p. 4。图中蓝色数据路径表示计算流,红色控制路径表示三个全局 FSM 对 KeyGen、Encaps、Decaps 的协调。[1] p. 4, Fig. 1 and Table I
系统由四类主要模块组成:处理模块 PSM、PPAM、统一伪随机数生成器 UPRNG,以及种子、稀疏向量、稠密多项式和接口等存储资源。三种 KEM 操作共用这些模块;全局 FSM 负责在不同阶段切换数据源和写回目标,而局部模块只关心自己的 ready/valid 与地址协议。
论文的面积策略可以概括成一句话:把“算法上相似、时间上不一定同时发生”的工作放进统一模块,把“数据上相同、端口上容易冲突”的存储放进共享寄存器库。Table I 还明确列出无 DSP 模约减、四路并行、三级重叠和统一 UPRNG 等设计选择。[1] p. 4, Table I
4.2 PSM:统一的四路采样模块#
【Paper】
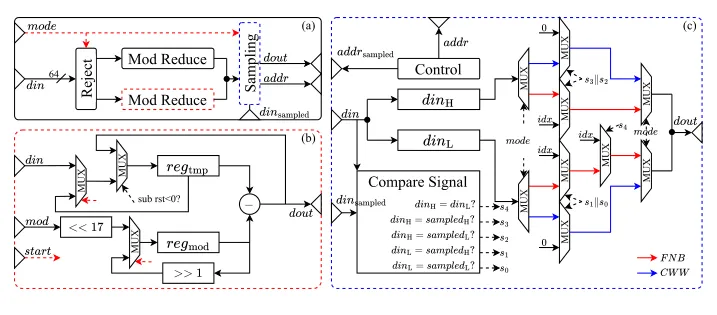
原文 Fig. 2,p. 5。PSM 将候选模约减、重复检查和有效索引提交组合为一个可切换模块。[1] p. 5, Fig. 2 and Section III-B
每个 32-bit 候选值先进入无 DSP 的移位-减法模约减器,再进入重复检测和有效性判断。对 HQC 参数,约减的模可以是 或 ;论文给出的实现使用 17 轮迭代,完整候选路径通常需要 19 个周期:装载、迭代和输出各占固定阶段。这样做牺牲了一个乘法器换来的单周期吞吐,但避免把 DSP 资源锁在一个只服务采样的运算上。[1] pp. 5-6, Fig. 3
PSM 每次接收四个候选,先把它们与已保存索引比较,再处理同一批次内部的两两重复。重量为 时,朴素重复检查次数为
四路比较把一次输入批次中的检查工作摊开,理想情况下检查规模接近 。奇数重量的最后一个无效 lane 会被 mask,不能把它误计入有效吞吐。CWW 为了避免提前结束造成不同输入对应不同周期数,采用完整扫描;FNB 则在两个候选中任一个越界、重复或不满足条件时原子地丢弃这一对。[1] pp. 6-7, Figs. 3-7
- 从 UPRNG 取四个候选值,并并行完成模约减。
- 检查候选对既有索引、候选对内部重复,以及 CWW/FNB 对应的范围条件。
- 若整批通过,则原子写入索引 RAM;否则丢弃无效 lane 或整对候选。
- 当有效重量达到目标值时,向 PPAM 发出下一批索引的 valid 信号。
【Code】 官方 RTL 的 src/PSM.v 将 CandidateGen 与 Sampling 连接成带 need/valid 和双口存储接口的模块;src/ModReduce.v 的 A 实现是显式的移位-减法状态机,src/CandidateGen.v 则包含 、 的范围检查和 CWW/FNB 选择。本文核对的提交为 1939f3a6b0e8fcd5a94407bf79ef15f6f603eeef。[2] commit 1939f3a6b0e8fcd5a94407bf79ef15f6f603eeef, src/PSM.v:102-180, src/ModReduce.v:28-105, src/CandidateGen.v:141-177
4.3 PPAM:四路稀疏-稠密乘法#
【Paper】
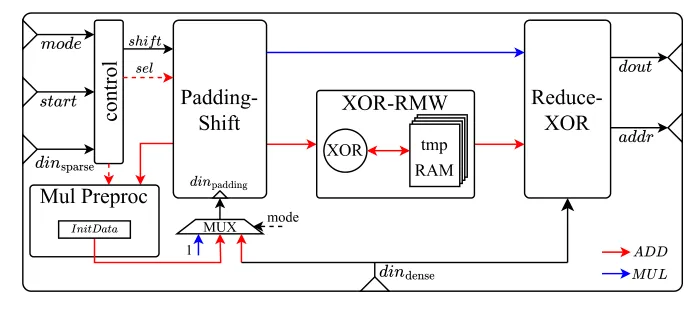
原文 Fig. 4,p. 6。PPAM 将四个索引批次映射到共享存储、移位和 XOR 累加路径。[1] p. 6, Fig. 4
PPAM 的基本操作是:读取稠密多项式的一个 128-bit word,根据稀疏索引的低 7 位做循环移位,再与对应累加值 XOR。若移位跨越 word 边界,需要从相邻 word 取数;论文把这一过程拆成 padding-shift、读改写和边界控制。对 的 HQC-1,,因此需要 139 个 word,最后一个 word 只有 5 个有效比特。
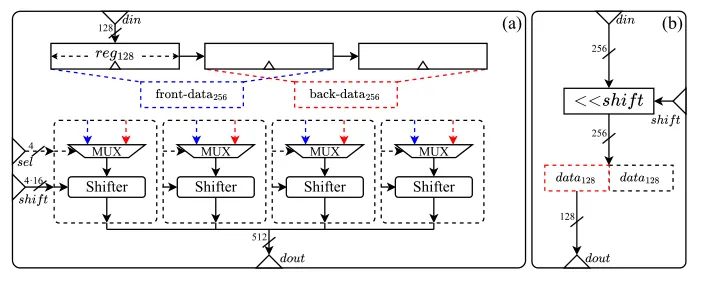
原文 Fig. 6,p. 7。一个共享寄存器库提供四路移位器所需的窗口数据。[1] p. 7, Fig. 6
旧式四路实现容易为每个移位器各保留一份稠密多项式副本。本文用共享寄存器库保存滑动窗口:一次读取的数据在局部寄存器中复用,再送入四个移位器。对索引 ,低 7 位决定 word 内移位,较高位决定全局 word 地址;跨界时用相邻寄存器补齐。这样减少的是“重复的稠密存储副本”,不是把所有累加 RAM 都消除。
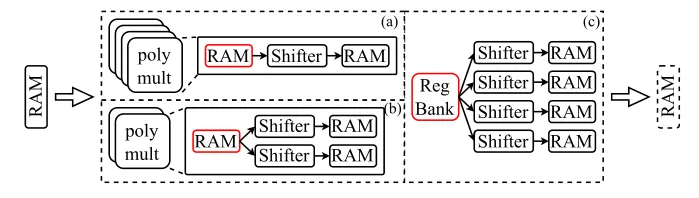
原文 Fig. 7,p. 7。边界 padding 与累加写回是共享寄存器库之外仍需独立处理的控制。[1] p. 7, Fig. 7
4.4 存储与调度:从完整批次同步到细粒度重叠#
【Paper】
PPAM 的存储组织可以分成四部分:临时累加 RAM、稠密数据 RAM、稀疏索引 RAM 和辅助 RAM。论文在系统级 FPGA 结果中报告总计 18 个 BRAM,其中 PPAM 临时累加占 8 个、稠密数据占 8 个、稀疏索引和辅助存储各占 1 个。共享寄存器库的作用是避免四份重复的稠密多项式 RAM,而不是让整个系统只需要一块 RAM。[1] p. 8 and p. 12, Figs. 8-9
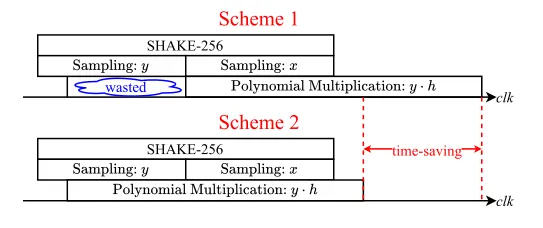
原文 Fig. 10,p. 9。四个索引写入后,PPAM 不等待整段采样结束就可以开始工作。[1] p. 9, Fig. 10
FGOES 把同步粒度缩小为“四个索引已经准备好”。在 PSM 继续产生下一批候选时,PPAM 消耗上一批索引,Encode 也可以把中间结果流入后续 XOR 归约。于是采样、稀疏乘法和编码不再严格串行,关键路径取决于三者在局部窗口内的最大服务间隔,而不是简单相加。
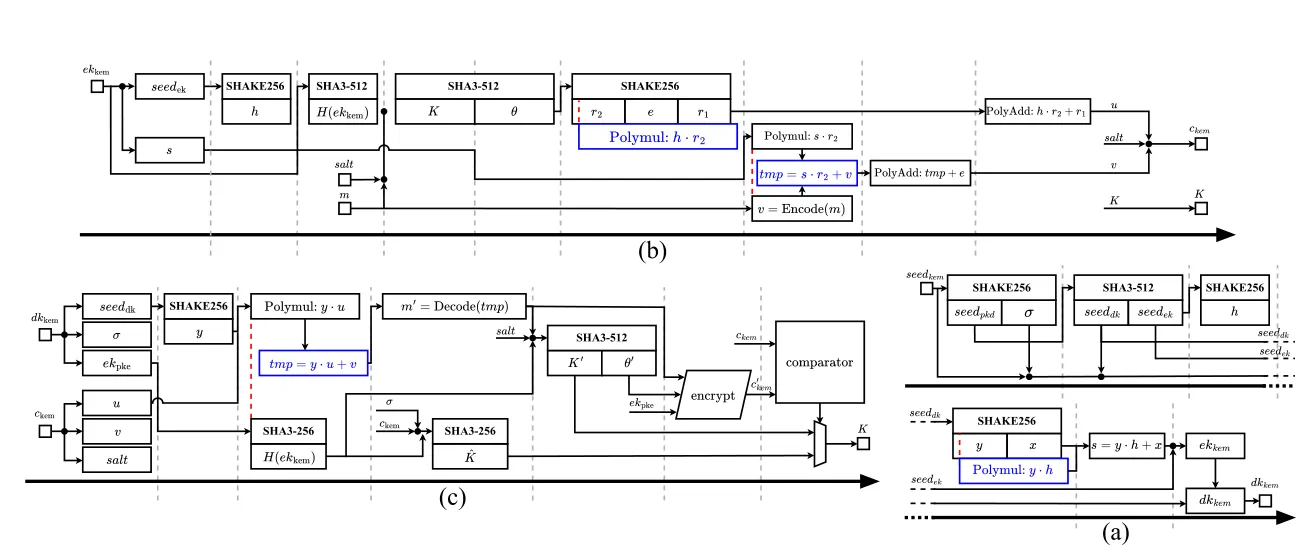
原文 Fig. 11,p. 10。不同 KEM 阶段复用同一重叠思想,但数据依赖决定了具体启动顺序。[1] p. 10, Fig. 11
论文给出的近似模型是:PSM 的双候选服务间隔约为 ,PPAM 消耗一批索引的时间与 相关。以 HQC-1 为例,,这解释了为什么 PPAM 仍可能成为长阶段的主导项;FGOES 的价值在于让这 139-word 过程尽早启动,而不是改变其基本算术量。[1] pp. 9-10, Eqs. (8)-(9)
4.5 代码 / RTL 实现对照#
【Code】
官方仓库是一个围绕 PSM 的 Verilog 工程,不是论文中完整 HQC 加速器的全部复现实验包。src/PSM.v 默认参数包含 DW=32、N_MAX=57637 和 OMEGA_MAX=149;CandidateGen.v 默认范围覆盖 17669 到 57637,并实现 CWW/FNB 相关候选控制。仓库的 README 要求 CentOS 7、VCS O-2018.09、Vivado 2019.1,并提供 make sim 与 make syn 入口。[2] README.md, src/PSM.v:32-42, src/CandidateGen.v:30-47
这份代码能核对 PSM 的接口和模约减骨架,但仓库中没有论文系统级表 IV 所需的完整 KeyGen/Encaps/Decaps 工程、完整 test vector 或可直接复现全部 FPGA/ASIC 数字的脚本。因此下面的系统结果以论文 PDF 为准,不能声称由仓库独立重跑得到。
5. 实验#
5.1 Experimental Setup#
【Paper】
| 项目 | 设置 |
|---|---|
| FPGA | Xilinx Artix-7 XC7A200T |
| FPGA 工具 | Vivado;论文表格报告综合后的资源、频率和周期 |
| 参数集 | HQC-1、HQC-3、HQC-5 |
| PSM 并行度 | 4 路候选 |
| PPAM 数据宽度 | 128 bit |
| ASIC 工艺 | 110 nm CMOS,目标频率 200 MHz |
| ASIC 状态 | 综合面积和 vectorless 功耗估算,非流片测量 |
论文的 FPGA 结果应当被理解为“该实现和该器件上的综合结果”,而不是所有 FPGA 的普适速度。ASIC 表 V 的功耗还使用了 10% 输入活动率,没有 workload VCD/SAIF;这会影响功耗数字的可比性。[1] pp. 10-13, Tables II-V
5.2 Main Results#
【Paper】
PSM 的原始结果如下;EqS 是论文使用的等效面积指标,DSP 为 0 表示该 PSM 实现没有使用 DSP。
| 参数 | LUT | FF | DSP | BRAM | EqS | Freq (MHz) | Cycles | Latency (µs) | ATP |
|---|---|---|---|---|---|---|---|---|---|
| HQC-1, | 363 | 356 | 0 | 0.50 | 196.75 | 254 | 931 | 3.67 | 721.16 |
| HQC-3, | 363 | 356 | 0 | 0.50 | 196.75 | 254 | 1843 | 7.26 | 1427.60 |
| HQC-5, | 363 | 356 | 0 | 0.50 | 196.75 | 254 | 3040 | 11.97 | 2354.80 |
PPAM 的结果则显示了统一四路数据通路的主要成本:LUT 与 FF 明显增加,BRAM 为 8,但论文没有在该表中报告 DSP 数量,不能把缺失写成 0。
| 参数 | LUT | FF | DSP | BRAM | EqS | Freq (MHz) | Cycles | Latency (µs) | ATP |
|---|---|---|---|---|---|---|---|---|---|
| HQC-1, | 3096 | 1865 | 未报告 | 8 | 2470 | 213 | 2519 | 11.83 | 29.21 |
| HQC-3, | 3096 | 1865 | 未报告 | 8 | 2470 | 213 | 7331 | 34.42 | 85.01 |
| HQC-5, | 3096 | 1865 | 未报告 | 8 | 2470 | 213 | 15367 | 72.15 | 178.20 |
以上对应原文 Table II 和 Table III,数值来自论文表格而不是按四舍五入后的频率重新推测。[1] p. 11, Tables II-III
5.3 资源与效率分析#
【Paper】
完整系统在 Artix-7 上的公共资源和频率为 LUT 22702、FF 12350、DSP 0、BRAM 18、EqS 9491.50、194 MHz。各 KEM 阶段的周期和延迟如下:
| 参数 | KeyGen cycles / µs | Encaps cycles / µs | Decaps cycles / µs | ATP |
|---|---|---|---|---|
| HQC-1 | 4767 / 24.57 | 9112 / 46.97 | 12361 / 63.72 | 1283.80 |
| HQC-3 | 11173 / 57.59 | 23548 / 121.38 | 31707 / 163.44 | 3250.01 |
| HQC-5 | 21783 / 112.28 | 45650 / 235.31 | 62765 / 323.53 | 6369.97 |
论文报告的 HQC-1 ATP 相对已有实现提升 2.05×、2.44×、3.49×、5.70× 和 11.02×;HQC-3 相对一个选定基线为 2.33×,HQC-5 为 2.25×。这里的“提升”是论文表 IV 的对比结果,不能把它解释成单独 PSM 或 PPAM 的加速比。[1] p. 12, Table IV and Section V-D
【Analysis】 用周期除以频率可以检查延迟量级。例如完整系统 HQC-1 Encaps 的 ,与表中一致。对单模块结果也能做同样检查:PSM 的 ,四舍五入后为 3.67 µs。它说明表格内部是自洽的,但不等于独立验证了综合约束、布局布线或测量环境。
5.4 ASIC 结果与边界#
【Paper】
110 nm CMOS 结果中,存储宏约 4.55 mm²,占典型工艺角总面积 5.59 mm² 的 81.4%。标准单元面积约 1.03–1.10 mm²,对应约 1097–1111 kGE;总面积在 TT/SS/FF 三个工艺角分别为 5.59/5.66/5.58 mm²,估算功耗为 122.80/98.41/166.40 mW。设置为 200 MHz、5 ns 时钟,I/O delay 30%,setup uncertainty 10%。[1] p. 13, Table V and Section V-E
【Analysis】 这组数字最重要的结论不是“ASIC 一定更省电”,而是 HQC 的存储宏已经是面积主项。继续复制并行稠密数据通路会很快被 BRAM/SRAM 面积吞掉;共享寄存器库和批次重叠只有在不把控制复杂度、端口冲突和时序裕量重新推高时才有意义。
6. 方法分析#
6.1 为什么有效?#
【Analysis】
这篇工作的收益来自三个依赖关系变化:
- PSM 把 CWW/FNB 的共同部分统一,减少两套候选生成、约减和比较硬件;四路输入又把重复检查摊到同一批次。
- PPAM 把四路移位器需要的窗口数据放进共享寄存器库,消除四份稠密多项式副本,同时保留四路 XOR 计算。
- FGOES 把启动条件从“整个稀疏向量已经生成”改为“下一批四个索引已经写入”,让采样延迟能够被 PPAM 的长乘法阶段覆盖。
因此,FGOES 的系统收益不是把公式中的乘法次数变少,而是降低了等待时间;PSM 和 PPAM 的局部资源则决定了重叠能否稳定维持。
6.2 核心创新#
【Paper】
- 统一 PSM:CWW 和 FNB 共享模约减、重复检查及提交路径。
- 无 DSP 的移位-减法模约减:在 FPGA 中以 LUT/FF 换取 DSP 空间。
- 统一 PPAM:四路乘法共享寄存器库、窗口数据和控制骨架。
- FGOES:在采样、稀疏乘法、编码/归约之间建立细粒度流水。
- 统一 UPRNG:共享 1600-bit Keccak 状态,并提供 64-bit 外部接口以服务 SHA3/SHAKE。[1] pp. 4-10, Table I and Figs. 1-11
6.3 与已有方法的本质区别#
【Paper】
| 维度 | 常见拆分式实现 | 本文实现 |
|---|---|---|
| 采样 | CWW/FNB 各自维护专用路径 | 一个 PSM 通过模式控制切换 |
| 稀疏乘法 | 每一路保留独立稠密数据副本 | 共享寄存器库驱动四路移位器 |
| 同步边界 | 采样完成后启动乘法 | 四索引批次到达即启动 PPAM |
| 存储代价 | 并行度增加时复制 RAM | 18 BRAM 的系统级组织,复制受控 |
| 评价重点 | 单模块或单阶段延迟 | 三种 KEM 阶段的系统级周期、ATP |
论文把统一模块、共享存储和三级重叠作为一个组合来评价;只抽取其中一项,很难复现表 IV 的系统级差异。[1] pp. 4 and 12, Tables I and IV
6.4 代价与适用条件#
【Paper】
统一 PSM 需要模式、范围和有效性判断;共享寄存器库需要跨 word 边界的 padding 与读改写控制;FGOES 需要更细的 valid/ready、写回和阶段依赖。因此,资源减少并不意味着控制逻辑免费。论文的 PSM 和 PPAM 单模块结果也显示,系统级性能依赖重叠是否能够长期保持,而不能只看某一块模块的频率。[1] pp. 5-10, Sections III-B to III-D
【Analysis】 这套设计最适合参数固定、任务重复、片上存储占主导的 HQC 加速器。如果目标是频繁改变 、、数据宽度或采样语义,统一控制器的验证成本会增加;如果外部内存成为瓶颈,减少片上副本也可能被总线等待抵消。
7. 局限性#
7.1 作者明确提出的局限#
【Paper】
论文给出的实现和评估仍有几个边界:FPGA 部分是特定 Artix-7 器件上的综合结果;ASIC 部分是 110 nm 工艺下的面积和 vectorless 功耗估算;官方代码仓库主要覆盖 PSM 相关 RTL,不能直接复现完整系统表格。论文还说明 CWW 的全扫描是为该路径消除提前终止带来的周期差异,并不等于对整个 HQC 实现完成了一般性的侧信道防护。[1] pp. 5, 13-14, Sections III-B and VI
7.2 自己分析得到的局限#
【Analysis】
- 表 IV 的系统结果缺少本文可独立运行的完整 RTL、test vector 和脚本;读者能核对结构和表格,但不能仅靠公开仓库复现所有周期。
- FGOES 把采样和乘法重叠后,平均吞吐可能提高,但最坏情况仍受无效候选、重复检查和边界 padding 影响;需要长序列统计而不只是一次 latency 才能判断稳定收益。
- 论文没有功耗轨迹、EM/功耗侧信道、高阶掩码或 profiling 评估。即使 CWW 路径使用全扫描,也不能据此推断系统具备侧信道安全性。
- ASIC 面积主要由存储宏贡献;迁移到不同 SRAM 编译器或更先进工艺时,BRAM/SRAM 宏比例、端口数和漏电特性都可能改变设计排序。
8. 启发与研究思考#
【Analysis】
- 假设 1: 如果把 PSM 的重复检查从全量历史索引改成分 bank 的摘要或布谷鸟式过滤器,平均采样延迟可能下降,但需要用精确比较作为误报后的确认路径;实验应分别统计候选拒绝率、最坏周期和额外 LUT。
- 假设 2: PPAM 的共享寄存器库值得继续沿着“动态窗口 + SRAM 预取”探索;最小实验是比较四路、八路和不同 word 宽度下的 BRAM、LUT、频率与边界 stall,而不是只比较乘法器数量。
- 假设 3: FGOES 可以扩展成带 credit 的弹性流水线,让 PSM 根据 PPAM 的 occupancy 调整候选生成速率;验证条件是低概率无效候选不会把 back-pressure 扩散到 Keccak 和 KEM 全局 FSM。
参考资料
- Jianxiong Zhang and Congwei Chen and Haolin Mai and Yanzhao Zhu and Beihai Tan and Xiaoming Xiong and Shuting Cai. An Area-Efficient HQC Accelerator With Unified Parallel Modules and Fine-Grained Scheduling. 2026. IEEE Transactions on Very Large Scale Integration (VLSI) Systems 原文
- Official code repository 原文;版本 1939f3a6b0e8fcd5a94407bf79ef15f6f603eeef