High-performance NTT accelerators for PQC:统一冗余算术与微调微架构
精读一套面向 PQC 的 FPGA NTT/INTT 加速器:用统一冗余 Montgomery 表示消除修正路径,再将 INTT 缩放和宽乘法映射进同一个高频 BFU。
论文用统一的冗余 Montgomery 表示去掉 NTT/INTT 蝶形中的两段条件修正,再把 INTT 除二和宽乘法一起做进 DSP 友好的 BFU,从而在不增加流水级数的情况下提高频率并降低 NTT 延迟。
1. 论文概述#
【Paper】 这篇工作面向 ML-KEM、ML-DSA 等格基 PQC 中反复出现的 NTT/INTT 核心,而不是完整的 KEM 或签名处理器。作者从一个可运行时配置模数的 parallel iterative NTT 加速器出发,重新设计统一蝶形单元(butterfly functional unit,BFU):允许系数落在扩展冗余范围内,取消乘法后和中间减法后的条件修正;同时把 INTT 的缩放操作并入已有加法路径,并将 Montgomery 乘法拆成适合 FPGA DSP 的层次化结构。[1] p. 2–3, Section 1
一句话总结#
【Paper】 用 的冗余 Montgomery 表示把 NTT 与 INTT 的中间值统一放宽到 ,再用 parity-aware 的加法/除二融合和 DSP 友好的 Montgomery 乘法,换掉关键路径上的连续条件修正,从而在相同流水深度下获得更高频率。[1] p. 16–22, Sections 3.2–3.4
核心贡献#
【Paper】
- 统一冗余算术。 把已有的冗余 Montgomery 乘法范围分析扩展到 INTT 中的 ,使同一个 BFU 可以在 NTT 和 INTT 模式下都省略乘法后修正,并进一步省略该 subtract–multiply 路径上的中间减法修正。[1] p. 16–20, Section 3.2, Figure 7
- 缩放与加法融合。 INTT 的一个除二被转移到离线 twiddle 预计算,另一个除二利用 为奇素数的 parity 关系并入模加路径,避免独立 scaling unit。[1] p. 20–22, Section 3.3, Figures 8–9
- DSP-centric 宽乘法。 对 17-bit 输入用 3 个 DSP 构造 Montgomery 乘法;对覆盖 ML-DSA 的 34-bit 输入进行层次化拆分,完整 Montgomery multiplier 使用 11 个 DSP,并通过六级流水满足 PE 阵列的低延迟约束。[1] p. 22–25, Section 3.4, Figures 10–11
- 端到端设计空间。 在 Virtex-7 上评估 、一维和二维 PE 阵列,并报告 14-bit 与 31-bit 模数宽度下的资源、周期、频率、延迟和功耗。[1] p. 27–31, Tables 2–4
2. 背景与相关工作#
【Paper】 NTT 把多项式乘法从系数域的卷积转到 evaluation domain 的逐点乘法;radix-2 蝶形反复执行模加、模减以及 twiddle factor 的模乘。硬件因此通常在两条路线上取舍:parallel iterative 架构用多 BFU 和多 bank memory 迭代复用同一个 NTT 数据流,pipelined 架构则用 SDF/MDC 等延迟网络减少不规则访存。无论选择哪一类,Barrett 或 Montgomery reduction 后的条件修正都会增加逻辑深度,INTT 还额外需要除以 的缩放。[1] p. 4–12, Section 2
作者把自己的位置放在已有的 unified butterfly、conflict-free memory mapping 和冗余表示的交叉处:PE 阵列和访存调度主要继承可配置 parallel NTT 的路线,新的重点是让 BFU 的算术输出不必在每一个局部操作之后回到 canonical range。论文特别比较了 runtime-configurable 设计、固定模数设计、BRAM-free 设计以及 DSP-heavy 设计,但没有声称跨所有 NTT 加速器“绝对最优”。[1] p. 6–12, Sections 2.1–2.4
【Analysis】 这篇论文的价值更接近 arithmetic/microarchitecture co-design,而不是新的 NTT 数学变换:它接受标准 radix-2 NTT 的数据流和已有的 conflict-free memory schedule,集中改变“结果什么时候必须被修正、缩放什么时候发生、宽乘法如何落到 DSP”这三个接口。收益的来源也因此比较可解释;代价则是所有中间信号多出 3 bit,并且最终优势依赖于 FPGA 的 DSP 形状、布线以及 PE 阵列能否消化这些宽 datapath。
3. 问题定义#
【Paper】 对长度为 、模数为 的多项式,radix-2 蝶形把两个输入 和一个 twiddle factor 变成:
INTT 使用相反方向的 twiddle,并在相应路径中完成除二;完整变换还需要最终的 缩放。论文将每个系数放在 Montgomery form,输入的 canonical 宽度为 ,但目标 BFU 不承担“每个小操作后都 canonicalize”的职责。[1] p. 4–5, Section 2
实现边界可以明确成四点:
- 运算范围: NTT/INTT kernel 及其 BFU/PE 阵列,不是完整 ML-KEM 或 ML-DSA 协议。
- 表示: 所有输入、中间量和输出采用 Montgomery form;冗余版本允许同一个 residue 由 或 表示。
- 参数化: BFU 支持运行时更换模数与预计算 twiddle,数据宽度决定可支持的模数范围;论文实验覆盖最多 14-bit 和 31-bit 模数。
- 优化目标: 在不增加 PE 流水深度的前提下,减少 correction/scaling 的关键路径,获得更高 Fmax 与更低绝对执行时间。
作者要求 NTT 模数是能提供所需 root of unity 的奇素数,满足 ;运行时更换模数时只需加载对应的离线 twiddle 表,datapath 不变。[1] p. 18–20, Section 3.2
4. 方法#
4.1 Overall Architecture#
【Paper】 加速器沿用 parallel iterative NTT: 个 PE 排成二维网格,每个 PE 包含一个统一 BFU;数据从左向右穿过 butterfly-style interconnect,同列 PE 之间不互连,输入从 memory 读入,经过多个 PE 后写回 memory。作者采用已有的 conflict-free mapping,让每个系数映射到唯一 bank 和 bank 内地址,从而在迭代 NTT 中同时支撑并行计算与并行访存。[1] p. 13, Section 3, Figure 4
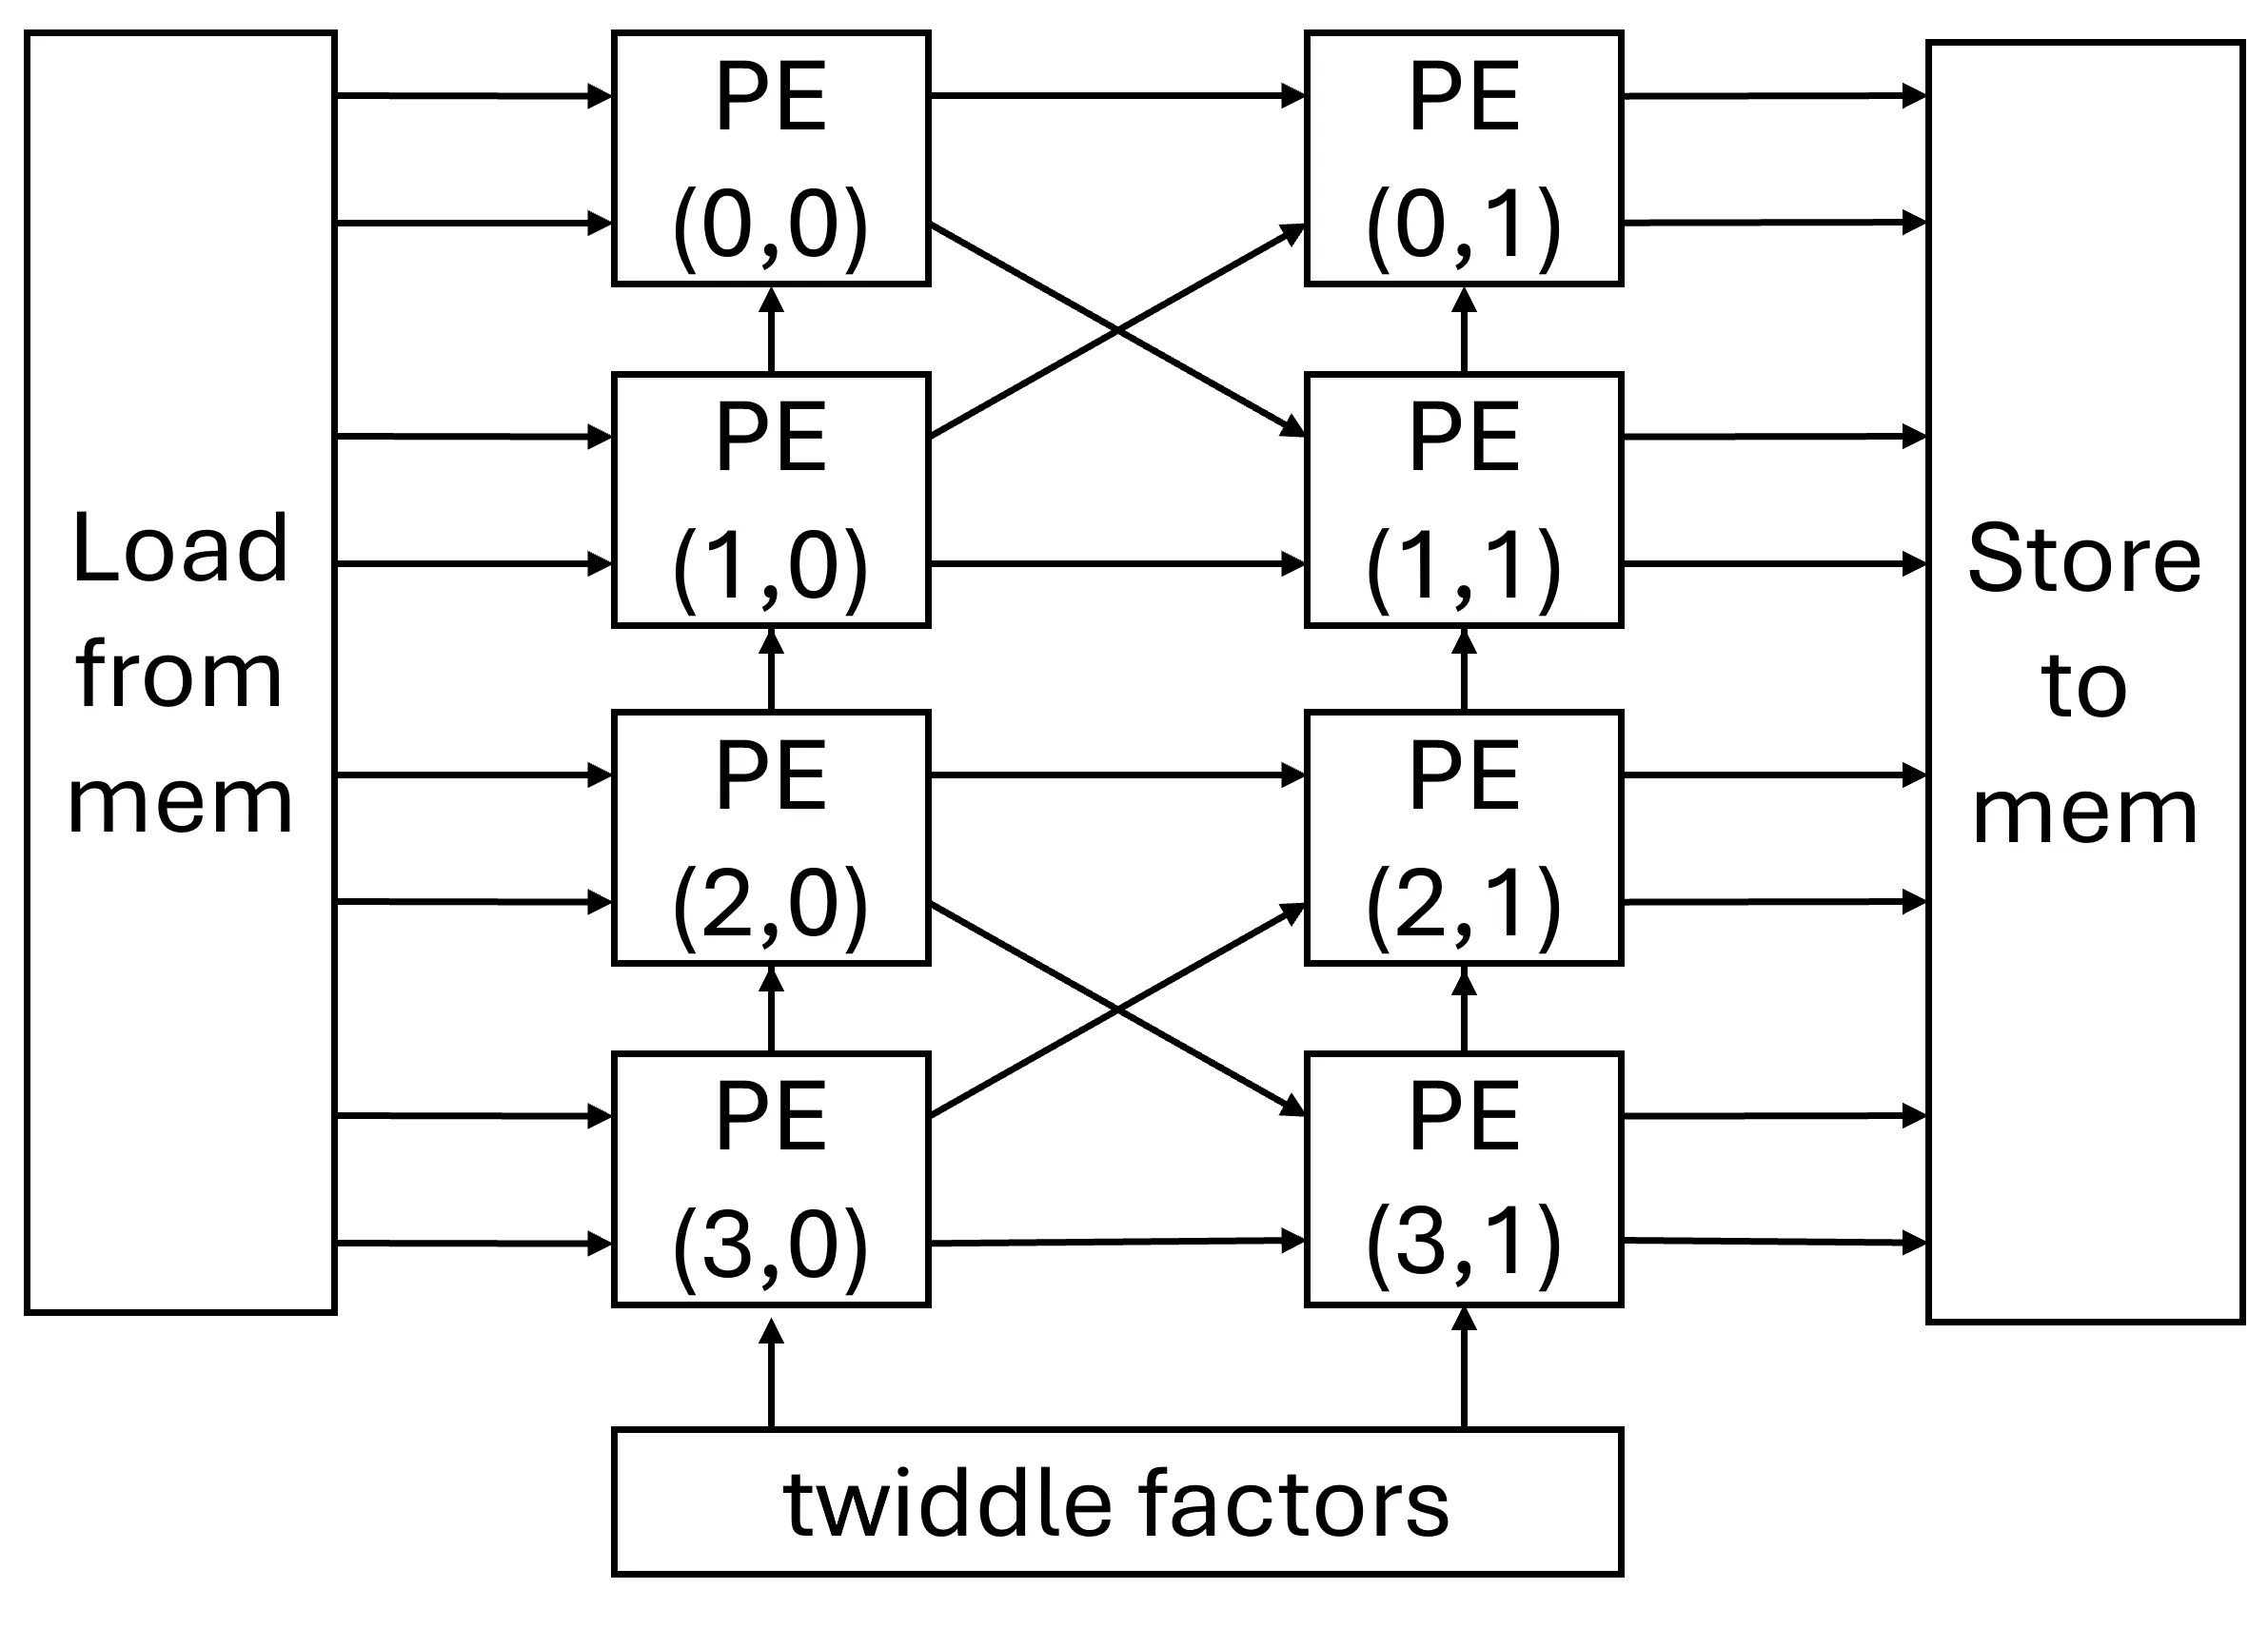
上图的关键不是一个新的 memory algorithm,而是说明 BFU 延迟会反过来约束 PE 阵列的可扩展性。论文沿用的无冲突、无 bubble 条件是:
其中 是 PE latency。低延迟 BFU 因而不仅影响单个蝶形的 Fmax,也决定 组合中哪些配置可以保持连续数据流。[1] p. 13, Section 3
4.2 核心机制:从 canonical correction 到统一冗余范围#
【Paper】 原始 unified butterfly 同时支持 NTT/INTT,但每个模加、模减和 Montgomery 乘法都假设输入输出位于 ,所以会串接 conditional correction。论文首先允许 NTT mode 的输入落在 ;对 INTT mode,则令 ,把差值改写成 ,使其与 一样落在 的中间范围。[1] p. 15–19, Section 3.2, Figure 6
令 Montgomery radix 为 ,并记 。对 INTT 的 subtract–multiply,论文给出的 Montgomery 形式是:
由于 、,乘积上界为 ;再利用余数项的上界,论文得到:
当 时,结果仍然落在 。于是乘法后 correction 和 subtractor 到 multiplier 之间的 correction 都可去掉;最终只需在蝶形输出端保留把结果拉回 的加/减修正。所有信号宽度增加为 ,并把 选成大于 的下一个二次幂。[1] p. 17–20, Equations (1)–(9), Figure 7
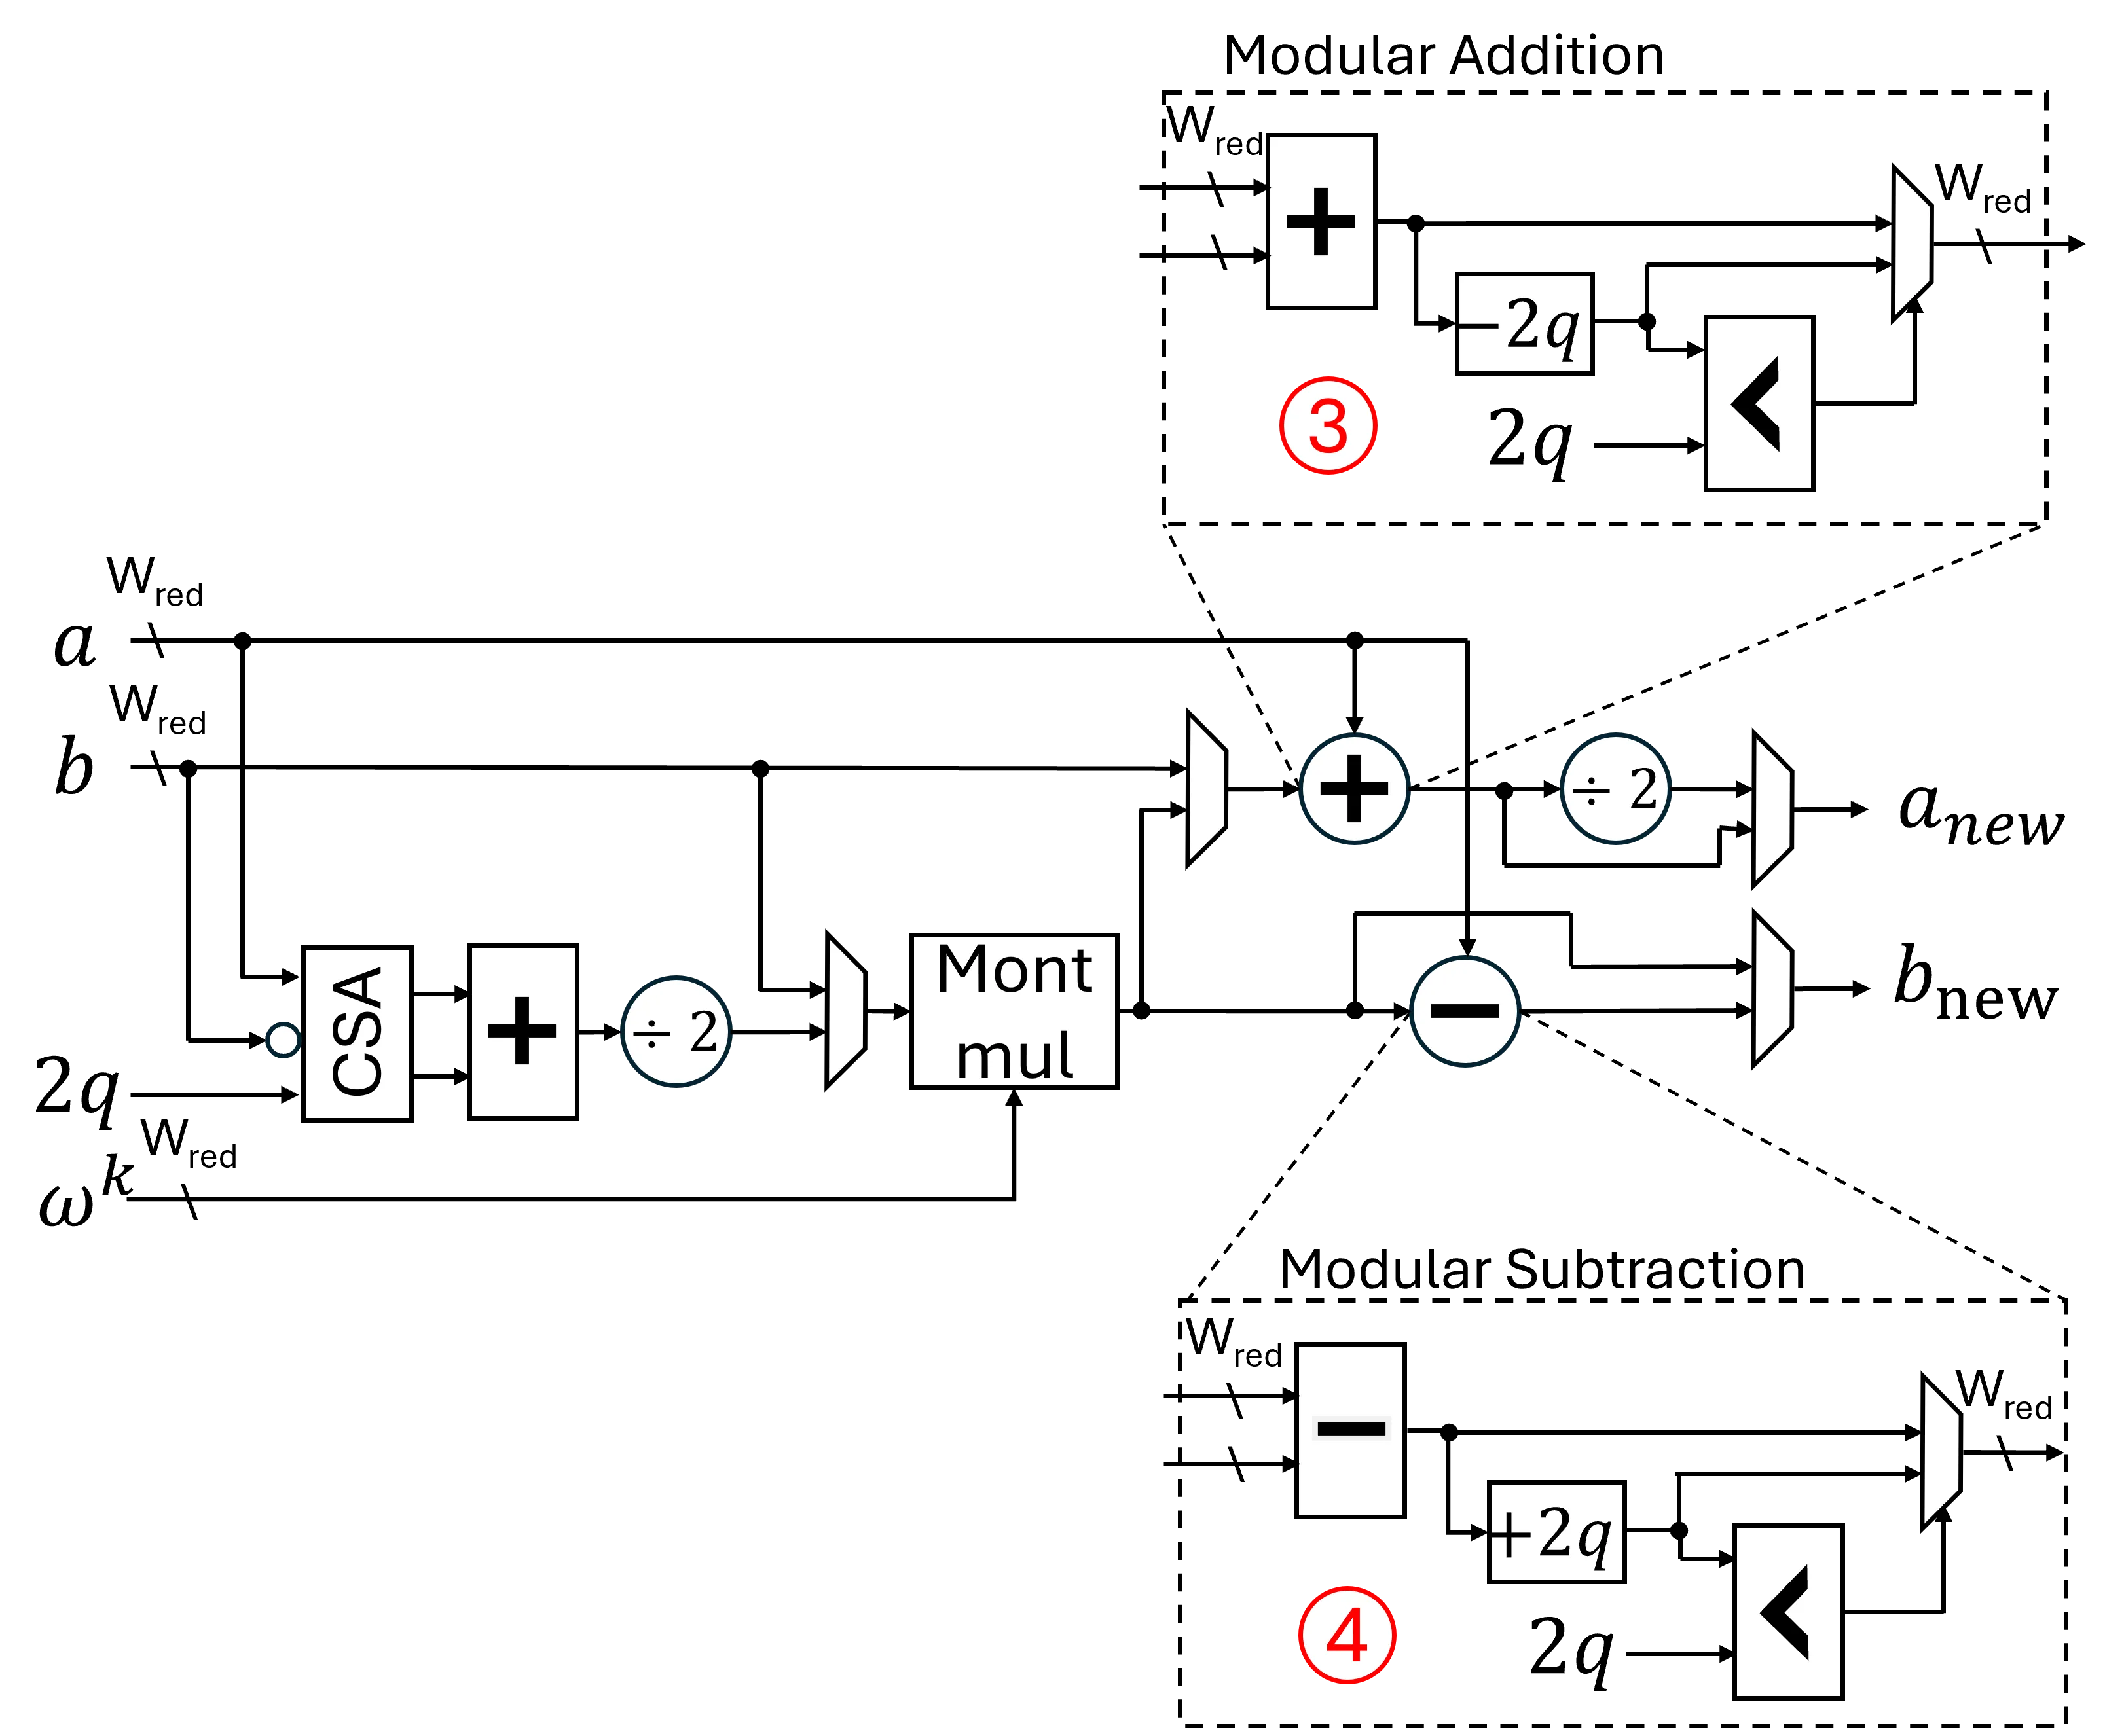
【Analysis】 这里的关键是“中间值不再独立可见”。 暂时可以超过 ,因为它马上进入 Montgomery multiplier,论文只需要证明组合后的输出重新回到统一冗余范围。这比单纯把每个 reducer 放宽更强:它改变了 correction 的依赖边界,把一段串行逻辑变成 multiplier 的输入契约。不过它也把正确性责任集中到 range proof 和所有后续消费者的接口约束上;如果将该中间节点复用于别的 datapath,当前证明不能直接复用。
4.3 INTT 缩放:离线 twiddle 与 parity-aware 加法#
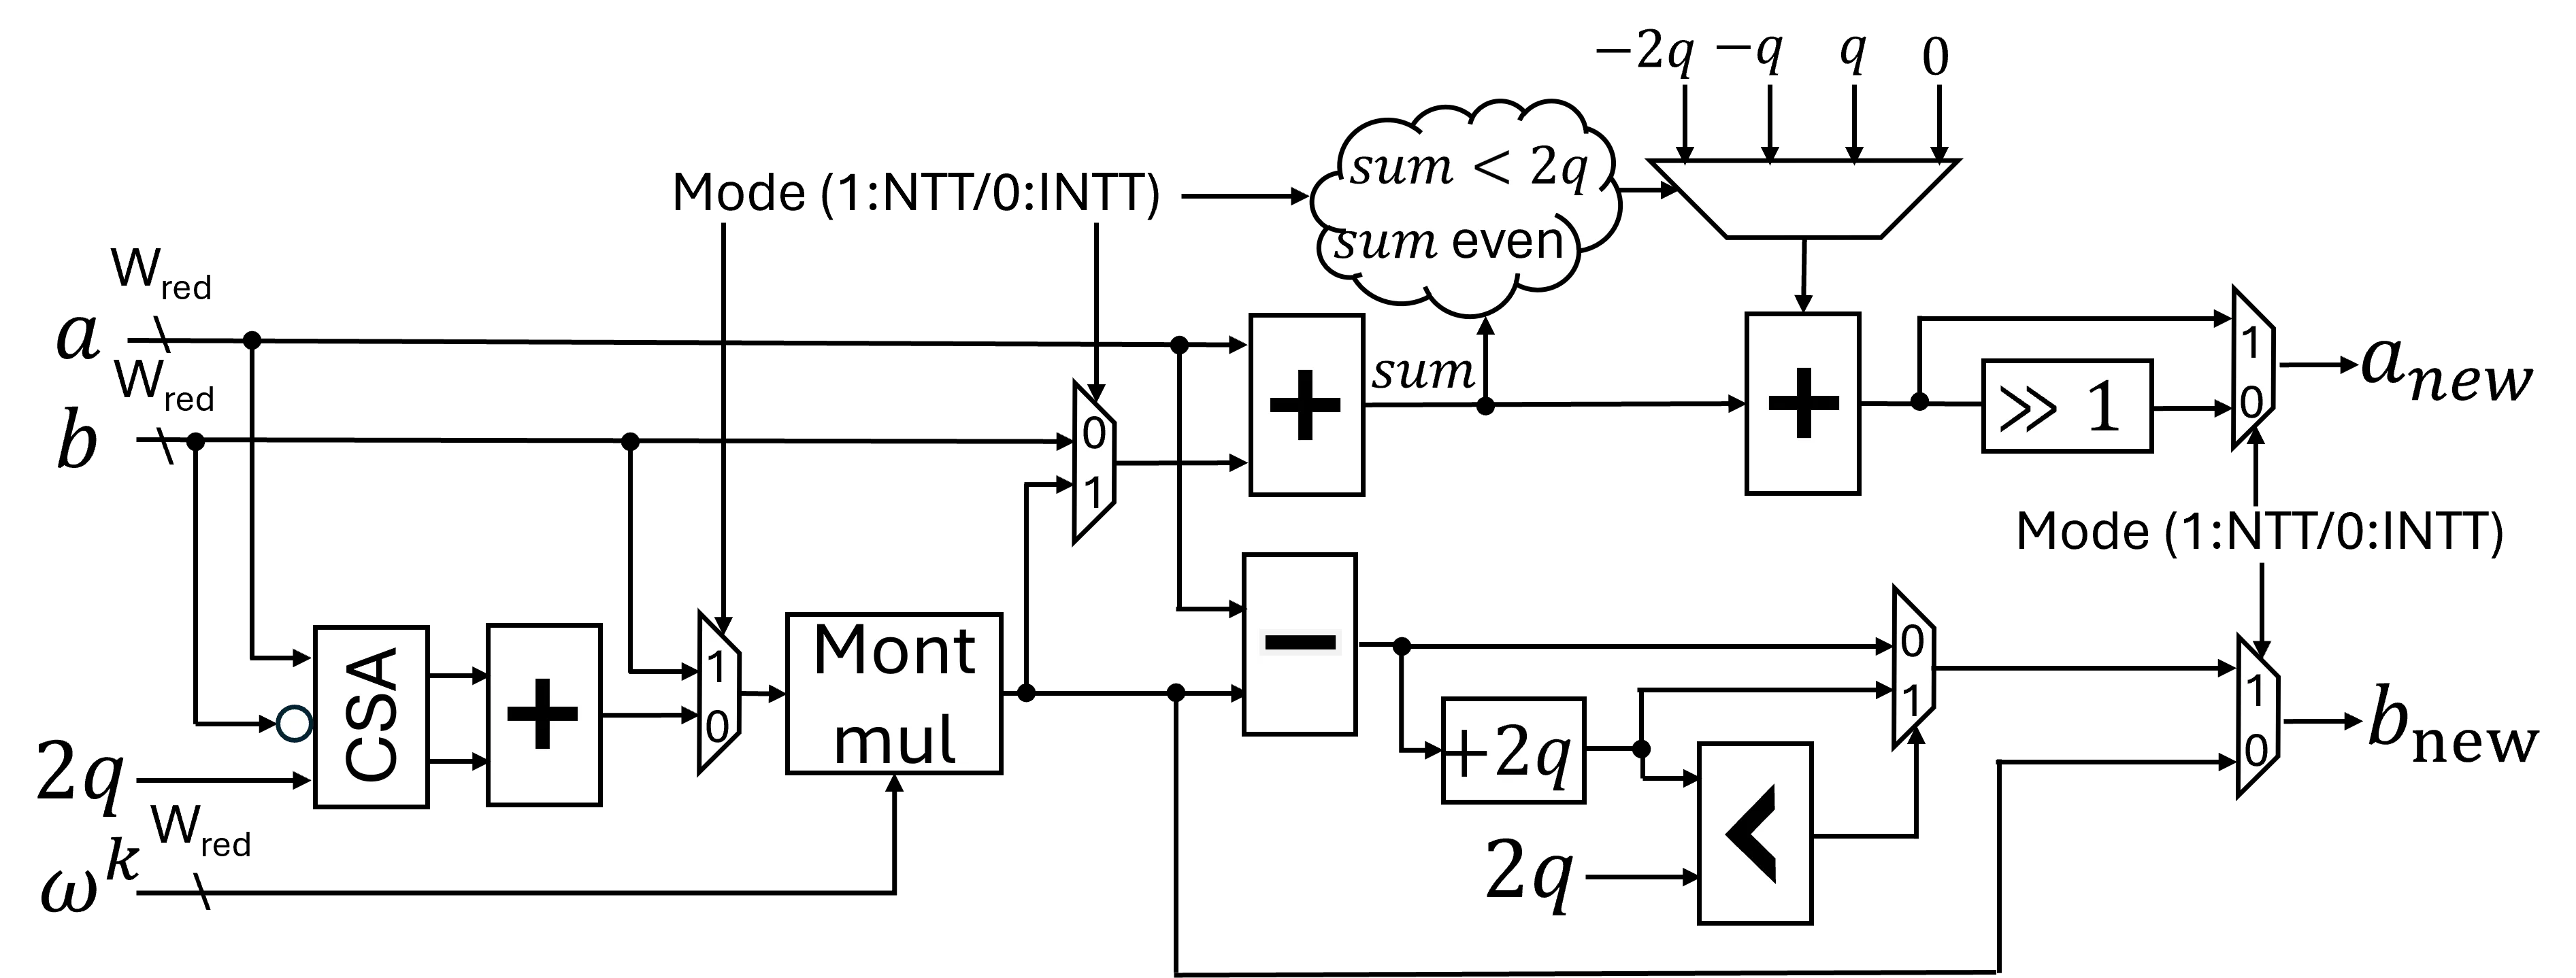
【Paper】 原 unified BFU 在 INTT 中有两个 divide-by-2 单元。第一处被转移到预处理:不再存储 ,而是离线计算 后写入 twiddle memory,因此运行时 multiplier 直接得到带缩放的常数。第二处位于 adder 输出,论文将模加与除二融合:加法器生成 和 ,再根据 的范围与奇偶决定加 、减 、减 或不修正,最后右移一位。[1] p. 20–22, Section 3.3, Figures 8–9
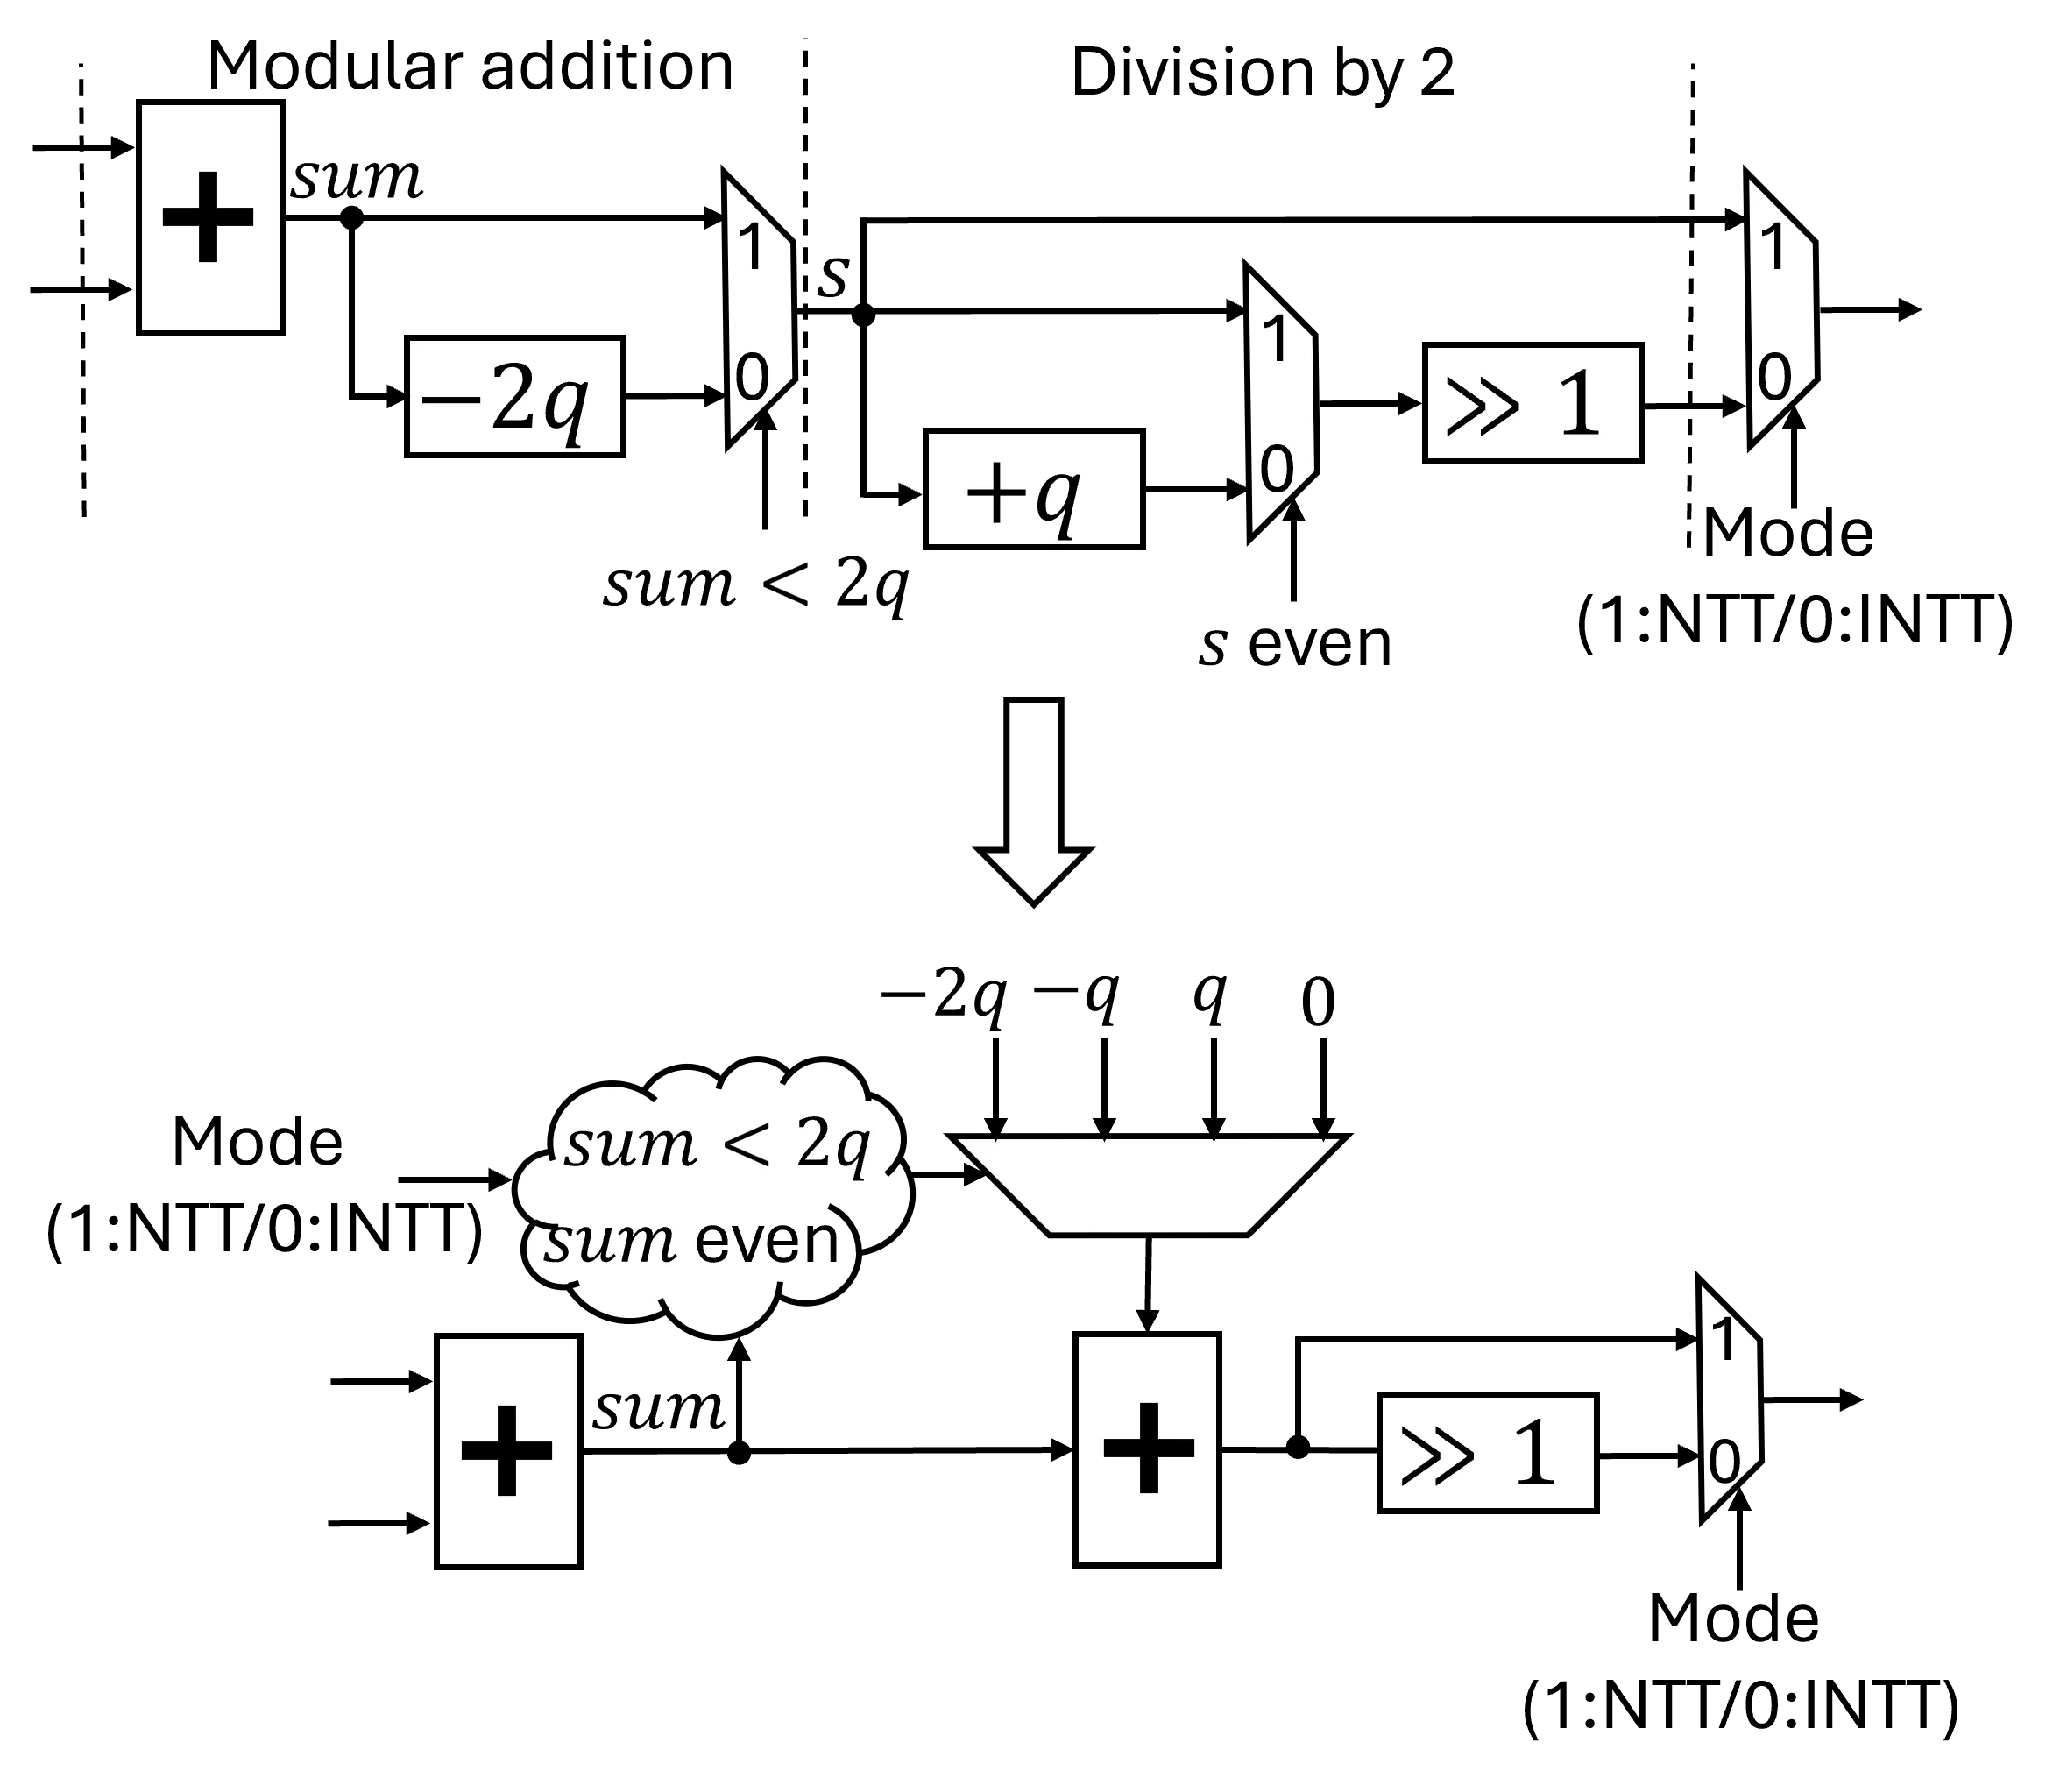
作者利用 为奇素数这一事实: 与 必有一个为偶数,因此除二之前只需要选择一个等价的偶数表示。四种情况可以压缩成一条控制规则:
- NTT 保持 或选择 ,只完成冗余范围修正。
- INTT / even 若 为偶数,直接选择合适范围的 或 后右移一位。
- INTT / odd 若 ,先加 ;若 ,先减 ,使输入变为偶数。
- 根据 mode、范围和 parity 选择常数路径,避免“完整模加 → 独立 correction → 独立除二”的串行组合。
4.4 算术与数据通路:从 17-bit 到 34-bit DSP 映射#
【Paper】 Montgomery multiplication 需要两个宽乘法、一个模 的乘法和一次加法。论文针对 Xilinx DSP48E1 的 signed 乘法与 48-bit accumulate 结构,不直接把 34-bit 乘法当作一个大黑盒,而是把它拆成 17-bit 子乘法。
| datapath | 论文中的映射 | BFU 级含义 |
|---|---|---|
| bit | 两个普通乘法各占 1 个 DSP,multiply-add 阶段占 1 个 DSP | 一个完整 Montgomery multiplier 使用 3 个 DSP |
| 34 bit | 每个宽乘法拆成四个 17-bit 子乘法,再用 carry-save/carry-propagate adder 合并 | 支持最多 31-bit 模数的冗余 BFU |
| 模 的乘法 | 为二次幂,最高位子乘法对最终低位结果没有贡献 | 第二个宽乘法少用一个 DSP |
| multiply-add | 使用 DSP 内部的 accumulate,避免额外 carry-save stage | 总计 11 个 DSP |
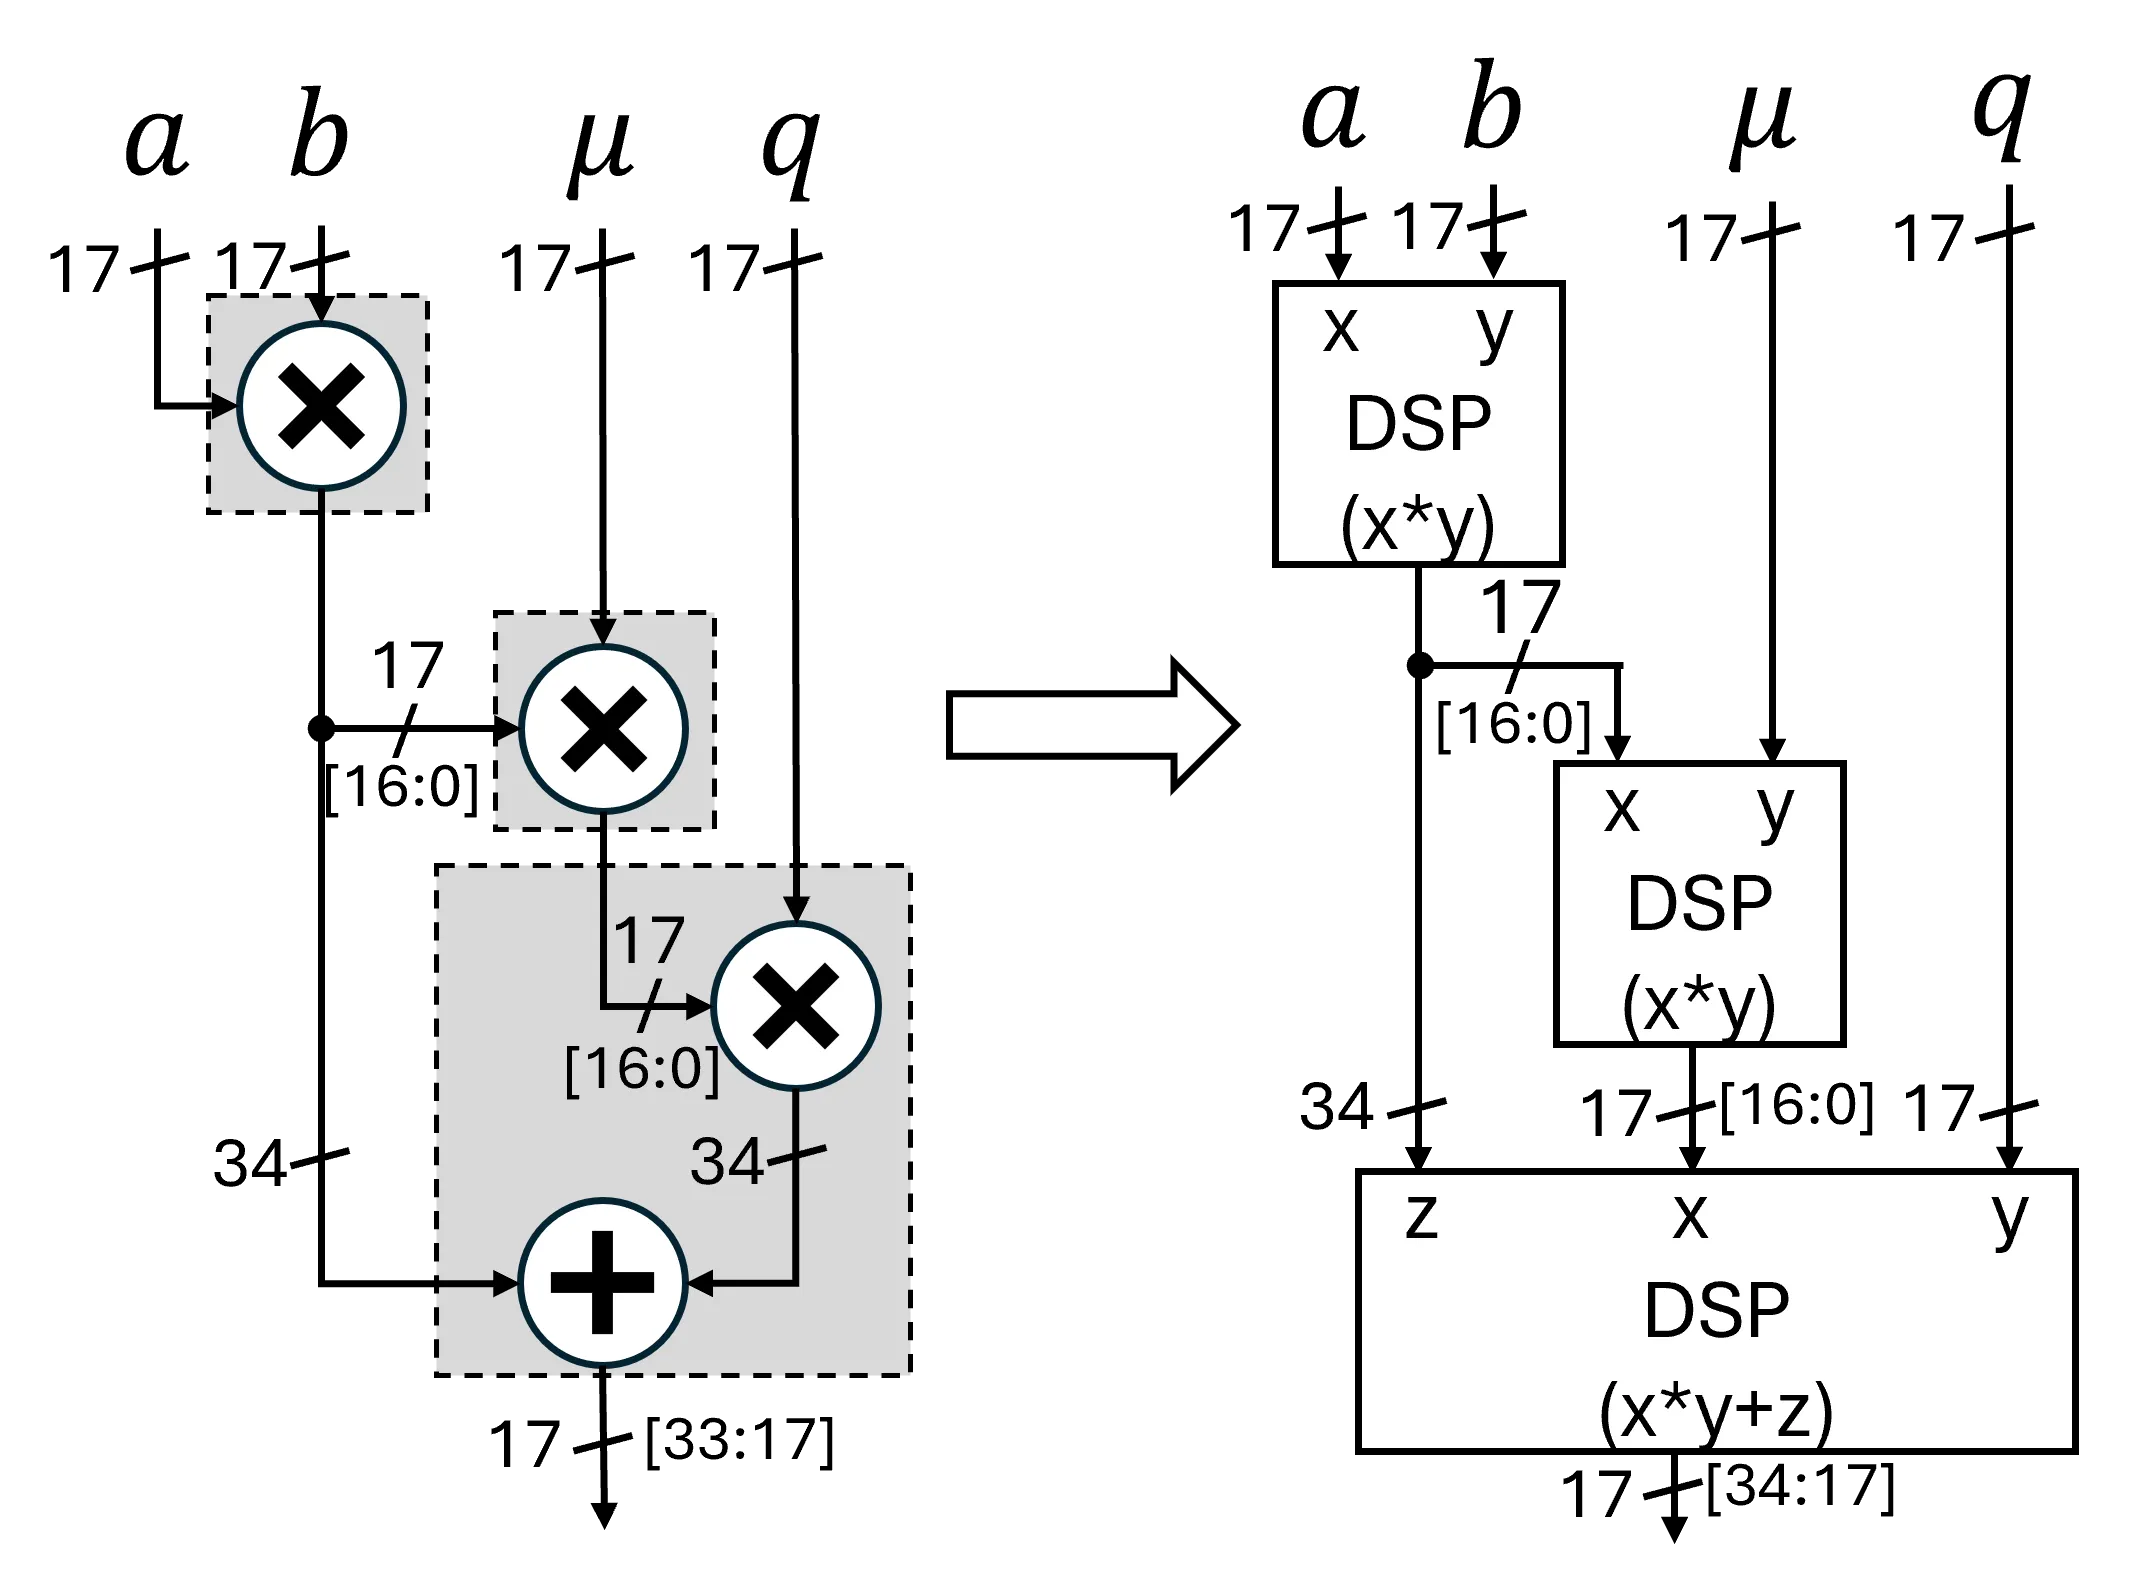
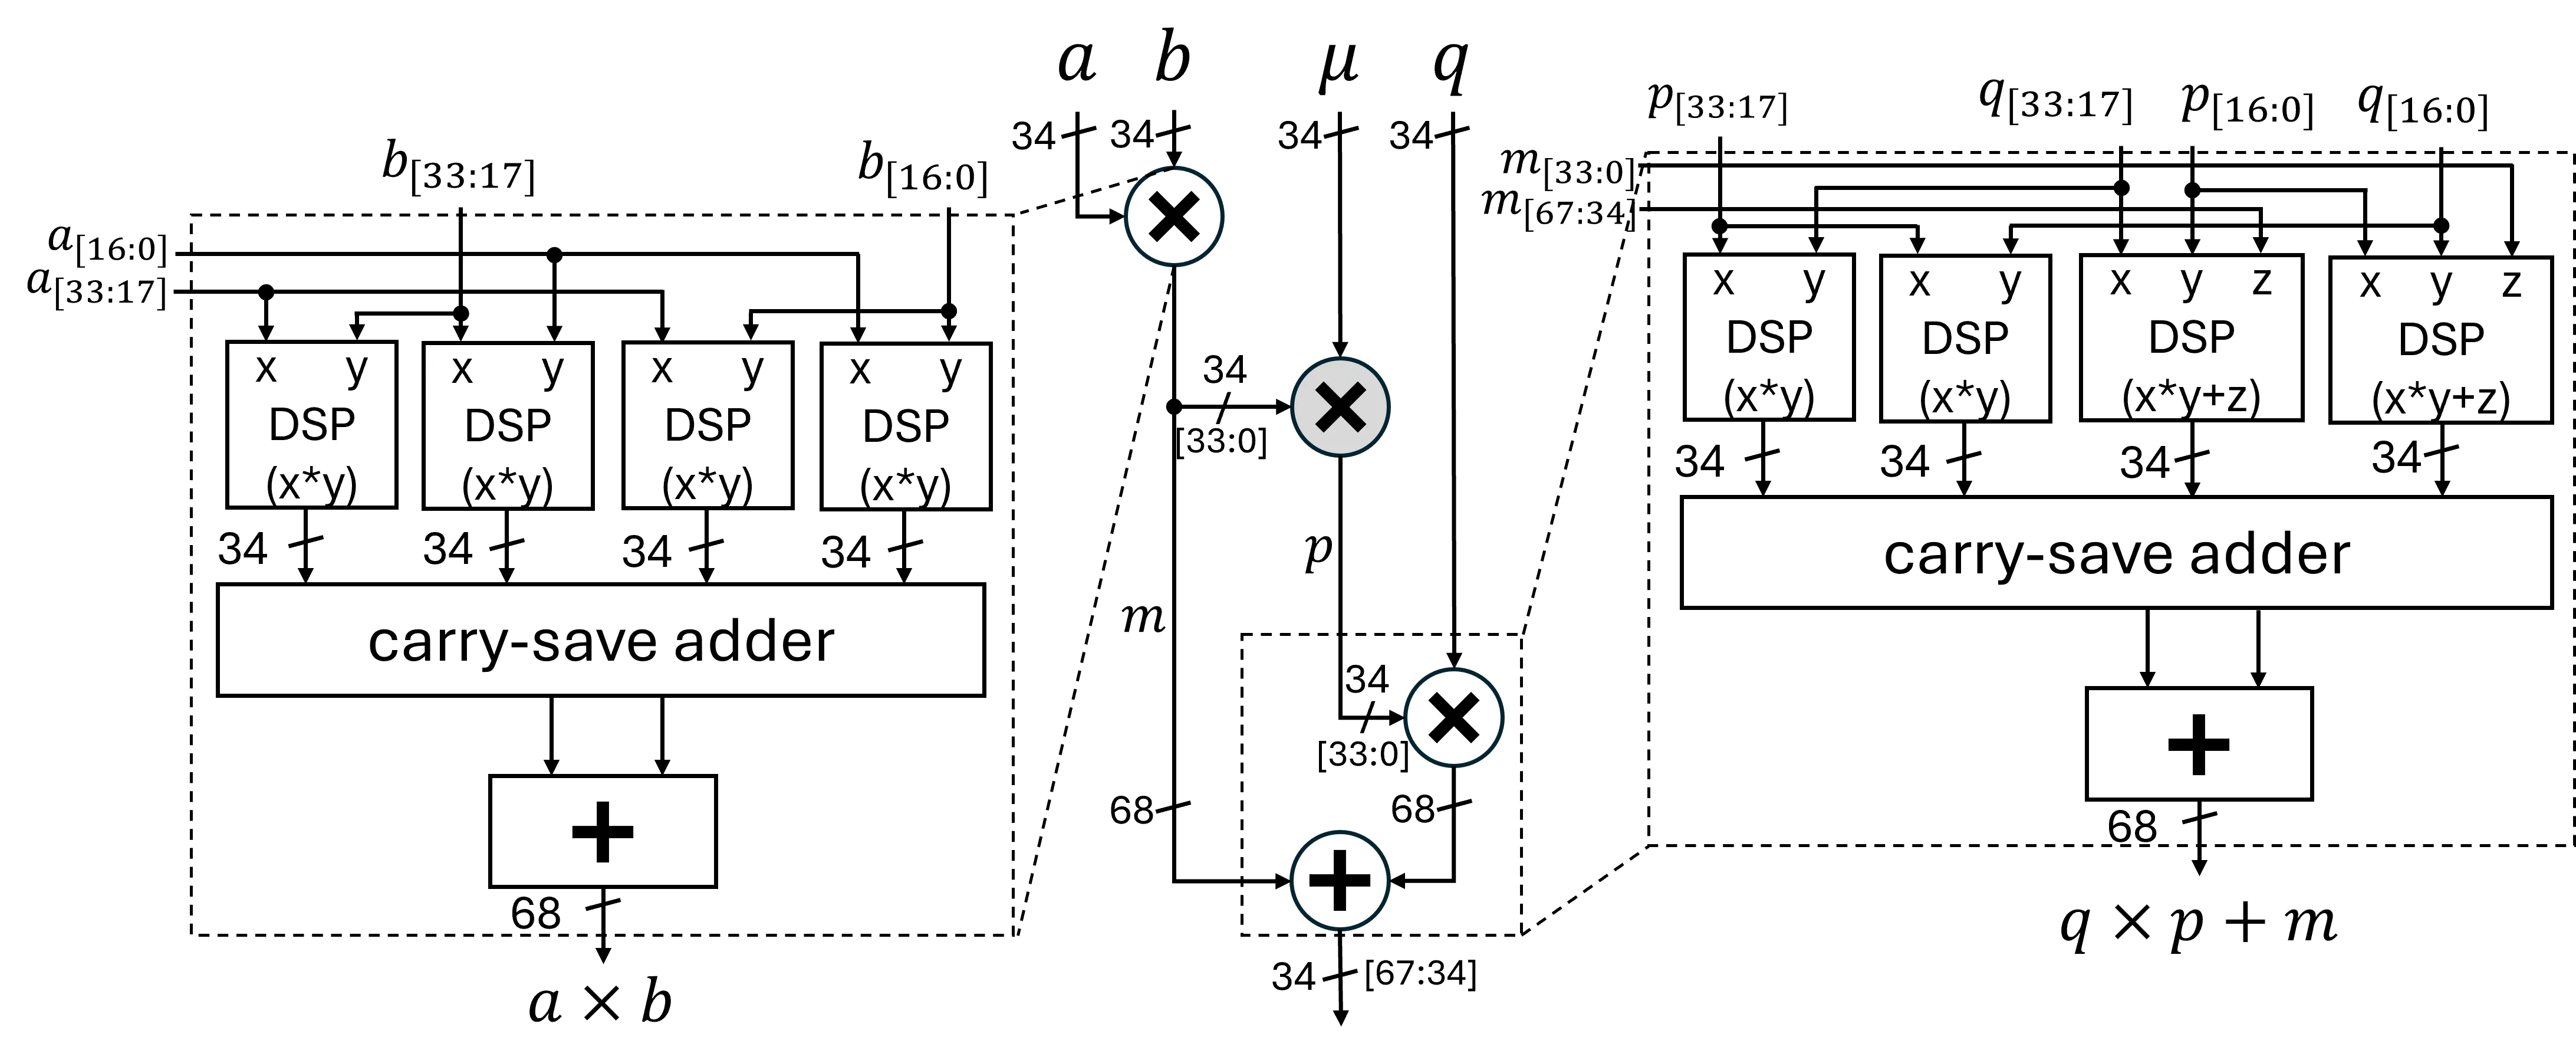
论文把每个 DSP 配置成两级流水,Montgomery multiplier 共六级,剩余两级留给 PE 内的其他操作;这使 PE latency 足够低,可以匹配前述无 bubble 条件,但也意味着它的频率上限仍受宽加法器和布线影响。[1] p. 24–25, Section 3.4
4.5 最终统一 BFU#
【Paper】 三个改动合并后的 BFU 保留 NTT 输出端的减法 correction,但删除乘法后 correction 与 subtract–multiply 中间 correction;INTT 的两个除二不再以独立模块出现。下图中加法器、减法器和 mux 处理冗余宽度,只有 Montgomery multiplier 负责乘法的模约减,控制输入切换 NTT/INTT 两种数据流。[1] p. 21–22, Section 3.3, Figure 9
5. 实验#
5.1 Experimental Setup#
【Paper】 论文使用 Vivado 2025.2 做 FPGA 评估;BFU 对比覆盖 Virtex-7、Artix-7 和 Alveo U200,完整 NTT 对比统一放在 Virtex-7 上。NTT 尺寸为 256、512、1024,PE 组织包括 、 和 ;本文设计针对最多 14-bit 与最多 31-bit 模数的两种 datapath。论文没有为所有表格统一说明 post-synthesis/post-route 边界,因此下表将其记录为 Vivado 实现结果;只有孤立 BFU 的 U200 频率脚注明确写作 maximum achievable post-implementation frequency。[1] p. 26–31, Section 4
| 项目 | 设置 |
|---|---|
| FPGA | BFU:Virtex-7 / Artix-7 / Alveo U200;完整 NTT:Virtex-7 |
| Tool | Vivado 2025.2 |
| Kernel | NTT/INTT BFU 与 parallel iterative NTT accelerator |
| NTT size | |
| Modulus width | 最多 14 bit()与最多 31 bit() |
| PE array | 、、 |
| Reported metrics | LUT、FF、DSP、BRAM、cycles、frequency、time、power |
| I/O / software | 未报告为完整协议边界;结果应理解为 kernel/accelerator 级硬件数据 |
5.2 Main Results#
【Paper】 下面先保留最能说明设计取舍的原始行;数字没有做跨平台归一化,time 是论文表中按 cycles 和 frequency 得到的微秒值。
BFU 对比#
【Paper】
| 设计点 | FPGA | reduction | 位宽 | cycles | LUT | FF | DSP | Freq (MHz) |
|---|---|---|---|---|---|---|---|---|
| Mu et al. | V7 | M | 13 | 7 | 173 | 122 | 3 | 286 |
| Coha-NTT | V7 | WLM | 12–30 | 4–7 | 703 | 474 | 8 | 174 |
| This work | V7 | M-red | up to 14 | 8 | 209 | 194 | 3 | 437 |
| This work | V7 | M-red | up to 31 | 8 | 580 | 481 | 11 | 391 |
| This work | U200 | M-red | up to 14 | 8 | 225 | 162 | 3 | 905 |
| This work | U200 | M-red | up to 31 | 8 | 572 | 501 | 11 | 496 |
在相近 13–14 bit 配置上,论文报告 Virtex-7 的 17-bit BFU 为 437 MHz,相比 Mu et al. 的 286 MHz 约为 1.53×;相对 Coha-NTT 的 174 MHz 约为 2.5×。更宽的 34-bit BFU 达到 391 MHz,而 Mu et al. 的 24-bit BFU 为 185 MHz。U200 上孤立 17-bit BFU 达到 905 MHz,相比 NTTGen 的 400 MHz 和 AutoNTT 的 250 MHz 分别约为 2.26× 与 3.6×。[1] p. 27–28, Table 2
完整 NTT 的代表性设计点#
【Paper】
| PEs | LUT | FF | DSP | BRAM | cycles | Freq (MHz) | time (s) | power (W) | ||
|---|---|---|---|---|---|---|---|---|---|---|
| 14 | 256 | 485 | 343 | 3 | 3 | 1032 | 437 | 2.3 | 0.78 | |
| 14 | 256 | 1546 | 1164 | 12 | 5 | 272 | 424 | 0.6 | 1.08 | |
| 14 | 256 | 6608 | 2194 | 24 | 12 | 136 | 402 | 0.3 | 1.87 | |
| 14 | 1024 | 592 | 369 | 3 | 3 | 5128 | 424 | 12.1 | 0.79 | |
| 14 | 1024 | 9942 | 5131 | 48 | 12 | 336 | 270 | 1.2 | 1.97 | |
| 14 | 1024 | 139172 | 12144 | 96 | 48 | 168 | 210 | 0.8 | 9.0 | |
| 31 | 1024 | 1276 | 808 | 11 | 3 | 5128 | 380 | 13.5 | 0.93 | |
| 31 | 1024 | 15390 | 10236 | 176 | 12 | 336 | 245 | 1.4 | 3.14 | |
| 31 | 1024 | 158141 | 14289 | 352 | 48 | 168 | 200 | 0.9 | 10.8 |
论文完整 Table 3 还包含 、其他 PE 宽度以及对 Coha-NTT、AN 和 Scalable NTT 的对应行;这里不把不同模数、平台和 PE 组织压成一个排名。作者报告,在同一 Virtex-7、、14-bit、单 PE 点上,5128 cycles 与 424 MHz 给出 12.1 μs,相比 Scalable NTT 的 5127 cycles、278 MHz 和 18.4 μs,执行时间下降约 34%。在 2D 设计点上,14-bit、 的 配置以 1.2 μs 换取远低于 的 LUT/DSP/BRAM 使用;作者将二维阵列视作吞吐、资源和功耗之间更实际的折中。[1] p. 29–31, Table 3 and Section 4.2
5.3 资源与效率分析#
【Paper】 论文的原始数据呈现出三个稳定趋势: 从 256 增长到 1024 时 cycles 近似按 增长;模数位宽增大主要推高 LUT、FF、DSP,而不明显改变 cycle count;增加一维 PE 数量能显著降低 cycles,却会带来 LUT、DSP、BRAM 和频率下降。以 14-bit、 为例, 到 使 cycles 从 5128 降为 168,但 LUT 从 592 增至 139172,频率从 424 MHz 降至 210 MHz。[1] p. 29–31, Table 3
【Analysis】 用同一设计点重算 :5128/424=12.0943 μs,与论文报告的 12.1 μs 一致;5128/380=13.4947 μs,与 31-bit 的 13.5 μs 一致。对于 14-bit、, 相比 的 LUT 约减少 14.0×,但 latency 从 0.8 μs 变成 1.2 μs;这不是单纯的“更快”,而是用约 50% 的延迟增加换取一个数量级的资源下降。论文的 35%–73% 延迟改善应理解为对照表中匹配的 FPGA、NTT size、模数宽度和 PE 配置的结果,不能脱离这些边界外推成所有 NTT 加速器的统一倍率。[1] p. 3, 27–31, Sections 1 and 4
功耗只在本文设计的 Table 3 行中出现,对比工作没有报告功耗;论文也没有在表格附近明确功耗是板级测量、工具估算还是仅某个模块边界。因此本文保留原始 W 数值,但不把它当作与其他工作的可比 energy/op,也不把二维阵列的功耗优势当作已经完成的独立测量结论。
5.4 Ablation / Design-Space Exploration#
【Paper】 论文没有给出逐项去掉“冗余表示、除二融合、DSP 层次映射”的严格消融表;它主要通过 BFU 对比、不同位宽、不同 、不同 PE 阵列和 BRAM-free 对照来展示设计空间。与 BRAM-free 设计相比,论文的单 PE 方案用 485 LUT、343 FF、3 DSP、3 BRAM 和 2.3 μs,换来更小的 LUT/FF; PE 与 方案则把延迟降到 0.3/0.6 μs,但增加了存储资源。[1] p. 31, Table 4
【Analysis】 因而无法从论文现有实验中分离出“去 correction”对 Fmax 的独立贡献,也无法确认 2D 阵列的收益中有多少来自 BFU、多少来自 memory mapping。最小的补充实验应固定 PE 阵列和 Vivado 约束,分别打开三项优化,报告 critical-path slack、LUT/DSP、cycles 和 frequency;否则只能确认组合优化有效,不能确认每项优化的边际收益。
6. 方法分析#
6.1 为什么有效?#
【Analysis】 可以把论文的因果链压缩成:
canonical correction 串行路径 → 扩展冗余范围 → 中间值不再需要独立 canonicalize → BFU 组合逻辑更短 → 不增加流水级数也能提高 Fmax → 同一 cycle count 下 latency 下降。
INTT 的除二融合进一步消除了一个独立模块和一个级联依赖;DSP 层次映射则让宽乘法更多地停留在 FPGA 的硬核资源内部。三者叠加后,单 BFU 的 cycle latency 没有为了补偿 correction 而增加,但数据宽度和 DSP 数量随模数范围增大,这解释了“频率提升与资源增长同时存在”的结果。
6.2 核心创新#
【Paper】
- 数学/表示层: 用 的统一冗余范围覆盖 NTT 的乘法和 INTT 的 subtract–multiply,并证明组合输出仍回到 。
- 数据通路层: 通过 parity 与范围联合判断,把 INTT 的除二并入模加,删除独立 scaling unit。
- 实现层: 以 17-bit 子乘法为基本颗粒,把 Montgomery multiplier 映射到 DSP48E1,并对 34-bit 路径做 carry-save 与 DSP accumulate 协同。
- 体系结构层: 把低延迟 BFU 放回二维 PE 阵列和 conflict-free memory schedule,验证局部算术优化能传递到完整 NTT latency。
6.3 与已有方法的本质区别#
【Paper】
| 维度 | 常见 unified / configurable NTT | 本文设计 |
|---|---|---|
| 系数范围 | 通常在每个模运算后回到 | 允许统一的 冗余表示 |
| NTT/INTT BFU | 共享结构,但 correction 与 scaling 仍在 datapath 中 | NTT/INTT 共享 BFU,乘法后 correction 被删除,除二被融合/预计算 |
| subtract–multiply | 先做减法修正,再送入 Montgomery multiplier | 允许 直接进入 multiplier,由组合范围证明兜底 |
| 宽乘法 | 可能依赖通用乘法器或字级 reduction | 17-bit 子乘法、carry-save、DSP multiply-add 的层次映射 |
| 访存 | 需要处理 NTT stage 的冲突与 bubble | 沿用 conflict-free mapping,把优化重点放到 BFU latency |
| 代价 | canonical correction 的逻辑深度较高 | 多 3 bit datapath、更多 DSP,以及对 和预计算 twiddle 的依赖 |
这里的本质区别不是“使用了 Montgomery”本身,而是把表示范围作为 BFU 的接口契约:它允许 correction 从每个算术单元后面移除,而不是只在一个 reducer 内做局部优化。[1] p. 12–25, Sections 2.4 and 3
6.4 代价与适用条件#
【Paper】 该方法需要 ,因此所有输入、输出和中间信号增加 3 bit;模数变化时 twiddle factor 需要离线生成并重新加载;34-bit 版本为覆盖 ML-DSA 使用 11 个 DSP,明显高于 17-bit 版本的 3 个 DSP。PE 阵列还必须满足与 PE latency 相关的无 bubble 约束,否则局部 BFU 的频率收益可能被 pipeline stall 抵消。[1] p. 18–25, Sections 3.2–3.4
【Analysis】 适用条件可以具体化为:
- FPGA 必须有足够匹配的 DSP 与 BRAM 端口;如果设计转向 LUT-only、ASIC 或另一种 DSP 形状,17/34-bit 的打包优势需要重新综合。
- 运行时可配置模数有价值,但它会放弃固定模数 reducer 的极致专用化;在只服务 ML-KEM 的极小设备上,论文的频率优势未必抵消额外位宽。
- 二维 PE 阵列依赖 memory mapping 和布线质量。PE 数量继续扩大后,routing pressure、频率下降和功耗会成为新的瓶颈,不能只按 BFU 数量线性推理吞吐。
- 论文没有评估 masking、hiding、fault detection 或实际侧信道泄漏;对于真实 PQC 部署,冗余范围与数据相关的切换活动仍需单独验证。
7. 局限性#
7.1 作者明确提出的局限#
【Paper】 论文明确指出计算效率只解决部署问题的一部分,后续工作需要为 NTT 加速器加入抵抗侧信道攻击的物理安全 countermeasures。论文当前没有给出 side-channel 或 fault-injection 实验,也没有报告完整 ML-KEM/ML-DSA 协议级端到端延迟。[1] p. 37, Section 5
7.2 自己分析得到的局限#
【Analysis】
- 缺少逐项消融。 当前证据能证明组合设计优于若干对照点,但不能量化冗余范围、除二融合和 DSP 映射各自的贡献。
- 实现阶段边界不够统一。 论文说明使用 Vivado 2025.2,但没有为所有结果清楚区分 post-synthesis、post-route、板级测量与工具估算;跨工作频率比较需要把这个差异保留为证据缺口。
- 功耗口径不完整。 只有本文设计报告 W,且没有明确测量窗口、静态/动态组成或 I/O 边界,因此不能推出 energy/op 或功耗随吞吐的普适关系。
- 代码可复现性有限。 本文核验到的是论文与其 arXiv LaTeX/图像源;没有在论文页面发现作者公开的 RTL、Vivado 工程或综合约束,因此无法把 Figure 9 映射到真实模块、FSM 和 testbench。
- 安全性尚未闭环。 冗余值允许同一 residue 有多种表示,且 mux、加法器和 DSP 的切换活动可能改变功耗轨迹;这是需要实测而非凭 constant-time 控制推断的问题。
8. 启发与研究思考#
【Analysis】 这篇工作的可复用启发不是“把所有 NTT 都改成 34 bit”,而是把表示不变量写成硬件模块接口,再据此重排 correction、scaling、DSP packing 和 memory schedule。基于论文的证据,下面两个假设适合直接做最小 RTL/综合实验:
- 假设 1:冗余范围的收益存在一个由布线主导的拐点。 在 的 BFU 上分别打开/关闭乘法后 correction,固定六级 Montgomery pipeline,测 critical path、LUT、DSP、slack 和功耗。若去 correction 后 Fmax 增益在更宽 datapath 上消失,或新增 3 bit 的 routing cost 超过逻辑深度收益,则说明该方法的主要适用范围是 FPGA DSP 形状匹配良好的中等宽度,而不是任意大整数 NTT。
- 假设 2: 是由频率退化决定的 Pareto 区域,而非固定经验。 对 扫描 与 ,把 PE 数量、BRAM、DSP、Achieved Fmax 和 latency 放入同一张 Pareto 图,并显式计入 memory stall。若在换一代 FPGA 或换模数后 仍然在相同吞吐下拥有更低 ATP,则论文关于二维阵列“最实际折中”的结论只适用于当前 mapping/器件组合。
- 安全验证问题: 对 canonical BFU 与 redundant BFU 做相同输入分布、相同频率和相同 PE 配置的 TVLA/功耗采样,再比较冗余表示与 correction 删除对泄漏的影响;如果泄漏显著变化,说明算术优化必须和保护逻辑共同设计,而不能把侧信道安全留到协议层。
参考资料
- George Alexakis and Dimitrios Schoinianakis and Giorgos Dimitrakopoulos. High-performance NTT accelerators for PQC leveraging Unified Redundant Arithmetic and Fine-Tuned Microarchitecture. 2026. Microprocessors and Microsystems 124 (2026), 105309 原文