KHNTT 论文精读:从四路分解到可配置多项式乘法器
从四路分解与 Karatsuba 重组出发,解释 KHNTT 如何组织统一蝶形、交叉存储和流水调度,并结合 FPGA 结果分析并行度与可配置性的取舍。
KHNTT 用四路分解与 Karatsuba 减少模乘,再通过统一 radix-4 蝶形、交叉存储和流水调度,将运算节省落实到可配置的多项式乘法器。
1. 论文概述#
【Paper】 KHNTT 面向后量子密码中的多项式乘法:既要减少运算量,又要让计算、存储和控制在不同参数下协同工作。论文将四路分解、Karatsuba 重组和统一 radix-4 蝶形结合起来,再用交叉存储与连续装载安排数据流。[1] §I、§III–IV,pp.3410、3413–3419
一句话总结: 先把长多项式乘法拆成更省模乘的短变换与重组,再让各阶段共享计算资源,并及时供给数据。
核心贡献:
- 用四路分解缩短子变换,以 Karatsuba 复用交叉乘积,降低完整乘法的模乘次数。
- 设计统一 radix-4 蝶形,将 NTT、INTT 和重组中的乘加操作映射到同一数据通路。
- 将交叉写回、流水调度与 CTC/RTC 配置结合,在 FPGA 上给出不同并行度和参数下的资源、延迟与 ATP。
【Analysis】 这篇论文适合沿着“运算图如何成为硬件”来读。四路分解改变任务的大小,Karatsuba 改变任务间的依赖,统一蝶形与存储调度再决定这些任务怎样执行。贯穿全文的问题是:少做的模乘,最终能换来多少延迟和面积收益?
2. 背景与相关工作#
【Paper】 NTT 将多项式卷积转成变换域中的逐点乘法。一次完整乘法包括前向变换、点乘和逆变换,各阶段还需要保存中间值、访问旋转因子并组织系数顺序。随着并行度提高,存储端口和阶段衔接也会参与决定执行时间。[1] §II,pp.3411–3413
论文沿用了三类思路:PtNTT 类分解通过缩短子变换缓和单位根条件;Karatsuba用加减法换取更少的交叉乘法;高基数 NTT把更多计算合并到一次蝶形中,减少迭代层数。KHNTT 将它们组织成一套多项式乘法流程,并设计与之匹配的计算单元和数据布局。[1] §II–III,pp.3411–3415
【Analysis】 这里的设计难点在于:减少乘法会引入新的加减与中间结果,增加并行单元又会提高访存需求。读 KHNTT 时,值得同时跟踪两条线——每个结果依赖哪些运算,以及这些操作数在什么时候、从哪里进入蝶形。
3. 问题定义#
【Paper】 给定两个含 个系数的多项式 ,目标是计算
由于 ,高次项回卷时需要变号,属于负循环卷积。全文用 表示系数个数,用 表示模数位宽。[1] §II、§III-C,pp.3411–3415
| 项目 | 运算与配置说明 |
|---|---|
| 输入、输出 | 两个系数向量输入,一个模 的乘积系数向量输出 |
| 主要实验参数 | |
| 算术范围 | NTT、INTT、点乘及 KHNTT 重组需要的模加减、模乘 |
| 编译时配置 CTC | 综合前确定并行单元数、数据通路等硬件组织 |
| 运行时配置 RTC | 在已实现硬件的能力范围内切换参数,复用固定物理资源 |
| 不在测量范围内的完整任务 | 密钥生成、封装/解封装、签名/验签;这些任务没有对应的端到端结果 |
在素数域中,完整负循环变换需要本原 次单位根。四路分解后,子多项式长度变为 ,相应的完整负循环子变换需要本原 次单位根。这个条件决定了下一节为何能对 使用短变换。
4. 方法#
4.1 整体架构#
【Paper】
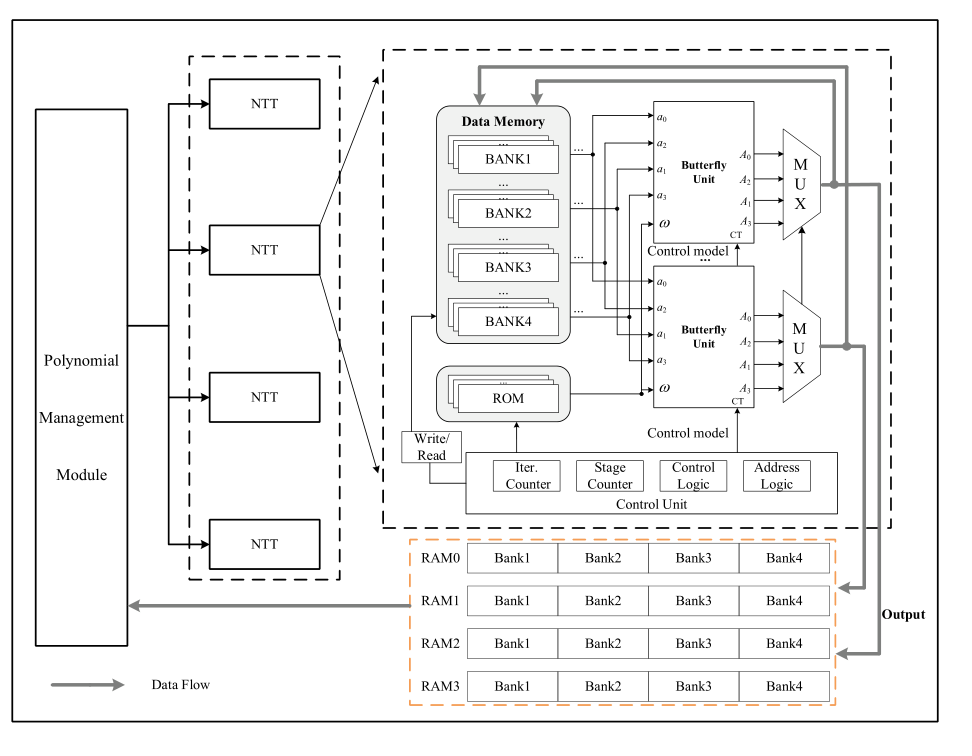
原文 Fig. 1,p.3416。图中展示的是算法分组与计算、存储资源之间的组织关系。
一次乘法从系数分组开始:管理模块将每个输入拆成四个子多项式,各组执行前向变换,再计算对角乘积和交叉项,组合出四组输出,最后逆变换并交错还原系数。计算模块读取分 bank 的数据存储和旋转因子存储,控制器负责阶段切换、地址生成与延迟对齐。[1] §IV-A,pp.3416–3417 BU(butterfly unit)表示蝶形计算单元。图中给出四路子变换及其内部的计算、存储组织;实验进一步比较了 4、8 和 16 BU 的设计点。[1] Fig. 1、Table III–IV,pp.3416、3420–3421
4.2 四路分解与 Karatsuba 重组#
【Paper】 令 、,将输入按系数下标对 4 取余分组:
同样分为 。子多项式位于 中,因此处理的是四个长度为 的问题。分组相当于将整个系数序列重排成四个步长为 4 的子序列。[1] §III-C、Algorithm 2,pp.3414–3415
例如 时,每组有 64 个系数。 满足 ,因此可以完成这些子变换;原始 256 点完整负循环变换要求的 则不成立。分解解决了子变换问题,接下来要把四组之间的交叉乘积组合回来。
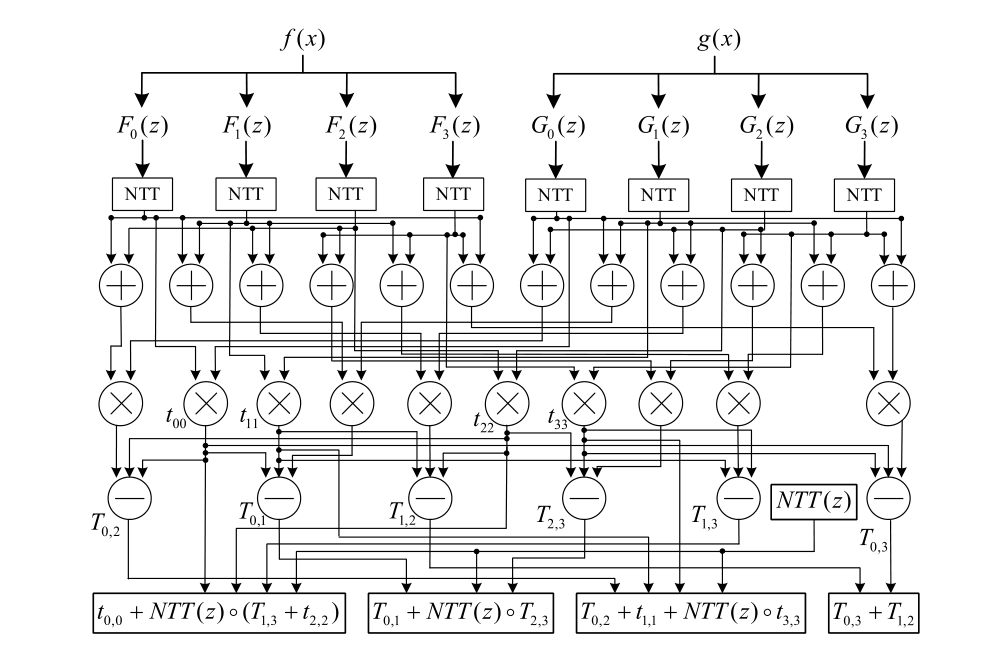
原文 Fig. 2,p.3417。每个 NTT 方块代表一组完整子变换,下方展开变换完成后的逐点乘法与重组。横向连线展示了中间结果如何被多个交叉项复用。
为了把重组过程写清楚,记 、, 表示逐点乘法。先计算四个对角项,再计算六个成对交叉项:
这样, 就由一次新乘法和若干加减得到。令 ,最终四组结果为
所有运算均模 。对 分别做 INTT,再放回下标 ,即可恢复 。式中的 对应跨过四组边界时引入的 因子,在变换域中通过逐点模乘参与重组。[1] Algorithm 2,第 16–18 行,p.3415
【Analysis】 上式包含四个对角乘积、六个交叉项乘积和三个 乘积,共 次标量模乘。再计入八次前向子变换、四次逆向子变换,并沿用论文“每个 radix-4 蝶形四次模乘”的计数口径,总数为
论文以 作为同口径 radix-4 完整乘法基线,所以节省的是 次模乘。 时为 ,减少 5.77%; 时为 ,减少 4.69%。绝对节省随 增长,相对比例则逐渐减小。这组数值衡量的是模乘工作量,硬件的资源与执行时间将在第 5 节一起比较。对于 ,这里的完整负循环基线用于运算计数对照,实际执行仍采用满足单位根条件的子变换。
论文的计数模型进一步比较分解深度 ,其中 (一次四路分解)取得最少模乘次数。[1] Eq. (8)、Fig. 6,pp.3414、3419 上述重组等式的独立检查覆盖五组参数、25 个输入用例,均与朴素负循环乘法一致;脚本及结果见文末资料。
4.3 统一蝶形与模约减#
【Paper】 radix-4 优化首先来自公共乘积的复用。用简化符号写一次蝶形:先形成 、、,再形成
四个输出组合为 ;具体输出地址服从变换的排列约定。这样一共需要四次模乘和八次模加减。论文对比的未优化形式为五次模乘和十二次模加减,因此蝶形内部模乘减少 20%,总算术操作数由 17 变成 12,减少 29.4%。[1] §III-A/B、Algorithm 1,pp.3413–3414
蝶形内部的公共乘积复用与上一节的分解优化作用于不同层次:前者压缩一次蝶形的算术操作,后者在采用这一蝶形后,进一步减少完整乘法的模乘总数。
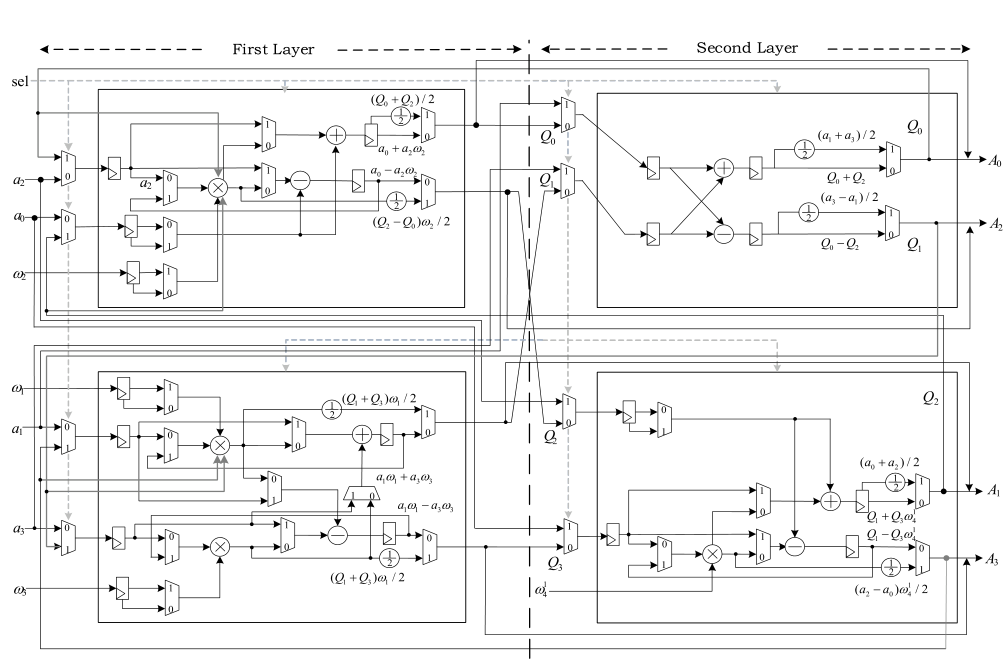
原文 Fig. 3,p.3417。选择器、寄存器和模除 2 路径,是复用与流水线对齐的实际成本。
统一 BU 通过路径选择复用模乘、模加减资源,以承担 NTT、INTT,以及 Karatsuba 所需的 类操作。逆变换中的缩放也进入数据通路。对奇数模数,模除 2 通过“偶数直接右移、奇数加 后右移”实现,选择器和寄存器负责路径切换与流水对齐。[1] §IV-B,p.3417
模约减采用改进 Barrett 方法:提前准备与模数相关的近似倒数,将常数表示成带符号的二次幂之和,以移位和加减替代约减内部的部分常数乘法。例如 。数据乘积 由乘法器产生,约减阶段再以移位、加减处理与模数相关的常数运算。[1] §III-D、Table I,pp.3415–3416
原文 Table II 在 下报告了以下约减器结果:
| 约减方法 | 流水级数 | LUT | FF | CARRY8 |
|---|---|---|---|---|
| Montgomery | 3 | 198 | 156 | 13 |
| Barrett | 3 | 135 | 92 | 8 |
| Fast modular reduction | 3 | 56 | 0 | 4 |
| K²-RED | 1 | 82 | 7 | 8 |
| 本文 optimized Barrett | 2 | 84 | 5 | 7 |
来源:Table II,p.3419。表中同时列出流水级数和原生资源,便于观察约减器在寄存器、组合逻辑与延迟之间的取舍。
4.4 存储组织与流水调度#
【Paper】 radix-4 蝶形每次处理四个输入和四个输出,并行计算要求存储系统同步供给这些操作数。论文把数据分 bank 保存,并在阶段结束时交叉写回,使下一阶段需要共同参与蝶形的系数分布到不同 bank。[1] §IV-C/D,pp.3418–3419
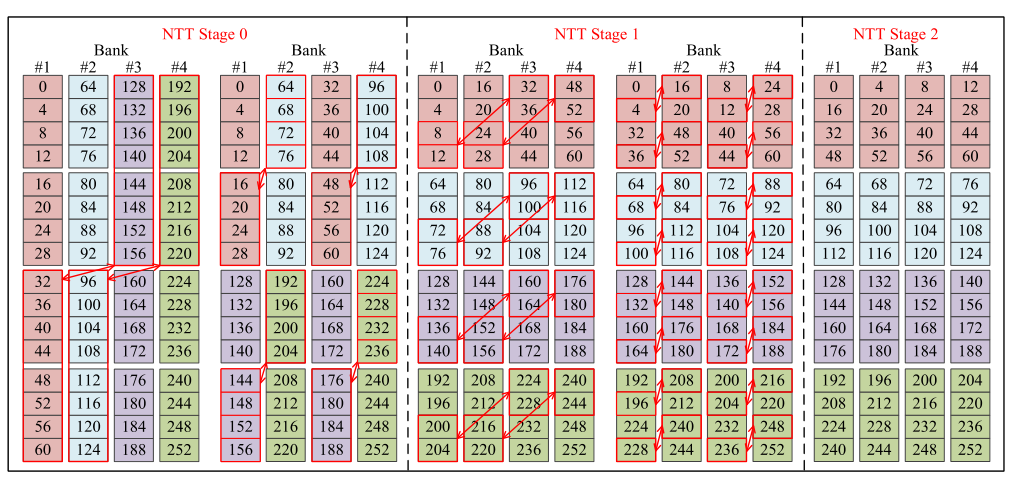
原文 Fig. 5,p.3418。图中数字沿用原始多项式的系数下标,展示一个 64 系数分组的三层 radix-4 处理。
以图中第一行的 为例,它们同属 ,却必须供一次蝶形从四个 bank 读出。它们的原始下标对 4 取余都为零,因此 bank 地址还要随子变换阶段与迭代位置变化。交叉写回的作用,就是把下一次蝶形需要的四个系数重新分散到四个 bank 中,并与流水线的读写时刻对齐。
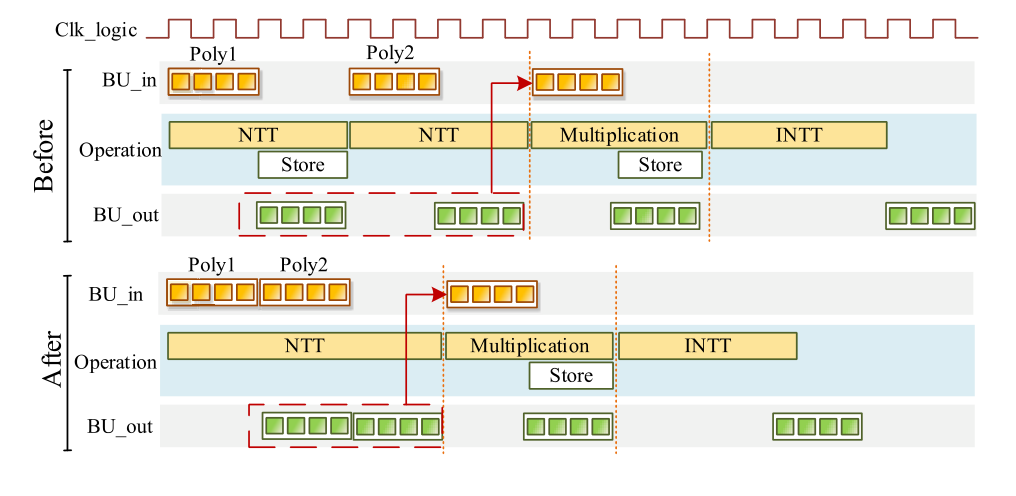
原文 Fig. 4,p.3418。连续装载两个输入并衔接计算,减少阶段间等待。
调度优化则让两个输入的流式装载与计算更紧密地衔接,缩短中间结果等待下一阶段的时间。论文的 1024 点示例中,总周期由 332 降至 295,数据传输等待由 76 降至 39。[1] §IV-C,p.3418
【Analysis】 在这一调度示例中,等待周期减少 ,总周期减少 ,整体获得约 加速。优化保留了计算任务,通过让装载和计算衔接得更紧密,缩短阶段之间的空闲时间。
4.5 官方代码与论文的对应关系#
【Code】 本次检查固定在官方仓库提交 6217c5312123 ↗。以下对照来自源文件静态阅读。[2] KNTT-C/kntt/kntt.cpp;PTNTT-Radix4-Python/poly_ptntt_radix_4.py;KHNTT-Hardware/256/src
| 文件 | 实际能确认的内容 |
|---|---|
KNTT-C/kntt/kntt.cpp ↗ | poly_2Iptntt_kara 包含按 分组、对子多项式变换以及 Karatsuba 交叉项组合 |
PTNTT-Radix4-Python/poly_ptntt_radix_4.py ↗ | 包含 radix-4 NTT/INTT、分组、旋转因子及数据文件生成;当前示例采用 PtNTT 的额外移位子多项式路径,与 Fig. 2 的十个基础乘积组织不同 |
KHNTT-Hardware/256/src/NTT_TOP.v ↗ | 有参数装载、旋转因子装载、数据装载,以及 NTT、INTT、系数乘法等操作码;计算计时与装载阶段分开 |
KHNTT-Hardware/256/src/modular_mul.v ↗ | q 写为 parameter q = 8380417,约减表达式使用固定切片;该文件没有运行时模数输入 |
256 点目录中,顶层提供参数装载接口,而模乘模块仍采用固定模数约减。复现 RTC 时,需要先确认所选工程中参数从顶层到约减单元的传递路径。该目录的 testbench 还使用机器相关的绝对路径,运行前要替换为本地数据文件路径。[2] KHNTT-Hardware/256/src/NTT_TOP.v:196;src/modular_mul.v:29;tb/tb_ntt.v
5. 实验#
5.1 实验设置#
【Paper】
| 项目 | 实验条件与测量范围 |
|---|---|
| 工具 | Xilinx Vivado 2019.2 |
| 实现阶段 | FPGA 综合、布局布线后的实现结果 |
| 器件型号 | xc7vx690tffg1761-2、xcku060-ffva1156-2、xc7z020clg484-3 |
| 表中平台缩写 | V7、X6、A7;下文保留原表标签,复现时应以具体 part 为准 |
| Table III | 单次 NTT 性能 |
| Table IV | 完整多项式乘法;表注描述为两次前向变换、一次点乘和一次逆变换的整体流程 |
| 配置类别 | CTC 与 RTC 分组比较;RTC 使用固定最大位宽的物理资源 |
| I/O 与配置开销 | 主机传输与参数切换开销的计入方式未报告 |
| 精确周期、启动间隔 II | 未为每个表格设计点独立报告 |
| 功耗 | 4 BU Virtex-7 配置的 Vivado Power Analyzer 实现后最坏情况估计为 0.631 W |
来源:§V、Table III–IV,pp.3419–3422。功耗为工具估计值,活动率与执行窗口未报告。
5.2 原始结果#
【Paper】 先看 Table III 的三个 Ours 单次 NTT 设计点。LUT、FF 和 DSP 分别与后面同参数 4 BU 的完整乘法配置一致,BRAM 则由这里的 12 增加到完整乘法表中的 16。
| 平台 | BU | MHz | 延迟(μs) | LUT | FF | BRAM | DSP | TP 原值 | ATP 原值 | |
|---|---|---|---|---|---|---|---|---|---|---|
| A7 | 256/12 | 4 | 264 | 0.28 | 3104 | 2240 | 12 | 32 | 10971 | 2.74 |
| X6 | 256/23 | 4 | 227 | 0.35 | 7984 | 6280 | 12 | 32 | 16823 | 5.15 |
| V7 | 1024/14 | 4 | 250 | 1.18 | 3916 | 3224 | 12 | 32 | 12149 | 12.602 |
来源:Table III,p.3420。TP 的单位问题在下一节说明。
Table IV 的 CTC 完整乘法结果如下,每行对应一个参数、平台和 BU 数确定的设计点。
| 平台 | BU | MHz | 延迟(μs) | LUT | FF | BRAM | DSP | TP 原值 | ATP 原值 | |
|---|---|---|---|---|---|---|---|---|---|---|
| A7 | 256/12 | 4 | 264 | 0.90 | 3104 | 2240 | 16 | 32 | 3408 | 10.01 |
| A7 | 256/12 | 8 | 247 | 0.78 | 6456 | 5440 | 28 | 64 | 3938 | 16.58 |
| X6 | 256/23 | 4 | 227 | 1.24 | 7984 | 6280 | 16 | 32 | 4748 | 19.86 |
| X6 | 256/23 | 8 | 205 | 1.11 | 16472 | 14400 | 28 | 64 | 5319 | 34.62 |
| V7 | 1024/14 | 4 | 250 | 4.05 | 3916 | 3224 | 16 | 32 | 3538 | 48.28 |
| V7 | 1024/14 | 8 | 229 | 2.60 | 7640 | 6336 | 28 | 64 | 5514 | 58.21 |
RTC 完整乘法的三个参数点共用 A7、16 BU、184 MHz,以及 32240 LUT、27744 FF、52 BRAM、128 DSP。
| 延迟(μs) | TP 原值 | ATP 原值 | |
|---|---|---|---|
| 256/12 | 0.71 | 4326 | 43.05 |
| 256/23 | 1.02 | 5772 | 61.85 |
| 1024/14 | 1.75 | 8192 | 106.1 |
来源:Table IV,p.3421。下方保留完整比较行,工作编号与比较倍数沿用 KHNTT 论文。
展开 Table IV 的完整比较数据
表中 * 表示原表选用本文 8 BU 结果比较,§ 表示选用 16 BU 结果比较;括号内为原表报告的比较倍数。k 为位宽。
CompSet:CTC
| 工作(原编号) | 平台 | n/k | BU | MHz | μs | LUT | FF | BRAM | DSP | TP 原值 | ATP 原值 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| [11] | V7 | 256/13 | 4 | 278 | 2.2 | 1288 | 888 | 4.5 | 12 | 1513 (2.25×) | 8.41 (0.84×) |
| [11] | V7 | 256/13 | 8 | 256 | 1.2 | 6245 | 1864 | 12 | 24 | 2773 (1.42×) | 14.68 (0.89×) |
| [32] | A7 | 256/12 | 4 | 273 | 1.13 | 4619 | 4166 | 16 | 8 | 2722 (1.25×) | 11.53 (1.15×) |
| Ours | A7 | 256/12 | 4 | 264 | 0.9 | 3104 | 2240 | 16 | 32 | 3408 | 10.01 |
| Ours | A7 | 256/12 | 8 | 247 | 0.78 | 6456 | 5440 | 28 | 64 | 3938 | 16.58 |
| [9] | X6 | 256/23 | 4 | 250 | 4 | 5478 | 4955 | 6 | 12 | 1475 (3.22) | 33.84 (1.7×) |
| [9] | X6 | 256/23 | 8 | 220 | 2.5 | 11006 | 8791 | 12 | 24 | 2355 (2.12) | 42.52 (1.22) |
| [9] | X6 | 256/23 | 16 | 194 | 1.98 | 26250 | 15171 | 24 | 48 | 2973 (1.69×)* | 75.91 (-) |
| [12] | A7 | 256/23 | radix-16 | 183 | 0.87 | 12720 | 7834 | 14.5 | 8 | 606 | 26.02 |
| Ours | X6 | 256/23 | 4 | 227 | 1.24 | 7984 | 6280 | 16 | 32 | 4748 | 19.86 |
| Ours | X6 | 256/23 | 8 | 205 | 1.11 | 16472 | 14400 | 28 | 64 | 5319 | 34.62 |
| [11] | V-7 | 1024/14 | 4 | 189 | 15.07 | 1467 | 930 | 4.5 | 13 | 951 (3.72×) | 62.06 (1.29×) |
| [11] | V-7 | 1024/14 | 8 | 179 | 8.05 | 3472 | 1789 | 7.5 | 25 | 1781 (3.10×) | 66.19 (1.14×) |
| [11] | V-7 | 1024/14 | 16 | 172 | 4.28 | 8515 | 3618 | 12 | 49 | 3350 (1.65×)* | 72.91 (-) |
| Ours | V7 | 1024/14 | 4 | 250 | 4.05 | 3916 | 3224 | 16 | 32 | 3538 | 48.28 |
| Ours | V7 | 1024/14 | 8 | 229 | 2.6 | 7640 | 6336 | 28 | 64 | 5514 | 58.21 |
CompSet:RTC
| 工作(原编号) | 平台 | n/k | BU | MHz | μs | LUT | FF | BRAM | DSP | TP 原值 | ATP 原值 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| [22] | A7 | 512/14 | 8 | 186 | 5.9 | 11000 | 5182 | 64 | 12 | 1215 (-) | 185.3 (1.75) |
| [22] | A7 | 256/23 | 8 | 140 | 5.307 | 11000 | 5182 | 64 | 12 | 1109 (-) | 166.7 (2.7×) |
| [22] | A7 | 512/14 | 32 | 126 | 3.4 | 63000 | 18000 | 48 | 256 | 2108 (-) | 350.2 (-) |
| [22] | A7 | 256/23 | 32 | 126 | 2.74 | 63000 | 18000 | 48 | 256 | 2150 (2.68×)§ | 282.22 (-) |
| [23] | A7 | 256/24 | 8 | 140 | 3.86 | 11100 | 8700 | 4 | 32 | 1591 (-) | 59.83 (0.97) |
| [23] | A7 | 256/24 | 32 | 135 | 2.63 | 44800 | 34500 | 16 | 128 | 2336 (2.47×)§ | 164.11 (-) |
| Ours | A7 | 256/12 | 16 | 184 | 0.71 | 32240 | 27744 | 52 | 128 | 4326 | 43.05 |
| Ours | A7 | 256/23 | 16 | 184 | 1.02 | 32240 | 27744 | 52 | 128 | 5772 | 61.85 |
| Ours | A7 | 1024/14 | 16 | 184 | 1.75 | 32240 | 27744 | 52 | 128 | 8192 | 106.1 |
原表 [12] 的 TP 为 606;按同一行 、、延迟 0.87 μs 代入表注公式,得到约 6768 Mbit/s。这里保留 606,并将该处记为原表的数值不一致。
5.3 如何解释吞吐率与 ATP#
【Paper】 原文的面积时间积定义为
这一论文自定义面积模型将 LUT、DSP 和 BRAM 加权相加,FF 单独列在资源表中。BRAM 的数量沿用原表计数,便于在同一口径下比较各设计点。[1] Table III–IV 表注
【Analysis】 用 A7、256/12、4 BU 完整乘法一行复算,可得 ,以及 ;原表写为 10.01。9.9936 是按公开数值精度计算的结果,10.01 为作者报告值,二者分别记录。
同一参数从 4 BU 增加到 8 BU 后,频率从 264 降至 247 MHz,延迟从 0.90 降至 0.78 μs,速度约提升 15.4%,原表 ATP 从 10.01 增至 16.58,增加约 65.6%。在 1024 点配置上,4→8 BU 带来约 1.56× 加速,ATP 仍由 48.28 增至 58.21。这几组结果呈现了清楚的取舍:更多 BU 缩短计算时间,新增算术、存储资源与频率下降则推高面积时间积。
吞吐率按作者表注的公式计算:
计算结果的量纲是 Mbit/s,但表头标成 MB/s。例如 RTC 的 1024/14 一行,,对应 8192 Mbit/s,即十进制 1024 MB/s。前面的表格因此使用“TP 原值”列名。该指标表示结果多项式位数与单次延迟之比;流水线稳态吞吐率还需要启动间隔 II。
阅读原表的比较倍数时,可以按“参数—器件—配置方式—BU 数”定位到对应行,再观察延迟与 ATP 的变化。这也便于区分同一架构增加并行度的收益,以及不同架构之间的资源取舍。
6. 方法分析#
6.1 为什么有效?#
【Analysis】 KHNTT 把一次乘法的成本分成三个可衔接的层次。首先,四路分解缩短每个子变换,Karatsuba 让对角乘积参与多个交叉项,减少重组中的模乘。其次,统一 BU 把前向变换、逆向变换和重组安排到同一套模乘与加减资源上。最后,交叉写回提前整理下一阶段的数据,连续装载缩短阶段间等待。
这三层设计之间有明确的依赖:运算图规定要做哪些计算,统一 BU 提供执行路径,存储和调度则让操作数按时到达。模乘次数下降提供了节省计算的空间,资源复用与数据供给决定这部分节省如何反映到完整乘法的实现上。
第 5 节的 4→8 BU 结果进一步展示了这个关系:并行度提高后延迟下降,同时频率下降、ATP 上升。对于短多项式,继续增加算术资源时,存储组织和物理实现的成本会变得更显著。
6.2 核心创新#
【Analysis】 我认为最值得提炼的是两点:
- 将分解后的运算图组织成可复用的数据通路。 四路分解产生短变换与交叉项,Karatsuba 进一步重排这些依赖,统一 radix-4 BU 则承接不同阶段的相近运算。
- 围绕这张运算图设计存储与调度。 中间结果怎样保存、下一组输入何时装载、下一层蝶形从哪些 bank 取数,都和算术复用一起设计。
它提供了一个具体的算法到架构的设计过程:先确定共享的乘积与中间结果,再安排执行资源和数据驻留位置。
6.3 与已有方法的本质区别#
【Paper】 论文讨论的已有路径与 KHNTT 可以从以下几个维度比较。[1] §II、§V
| 维度 | 本文讨论的已有路径 | KHNTT 的选择 |
|---|---|---|
| 运算分解 | 直接执行较长变换,或用 PtNTT 分解后处理额外交叉项 | 四路短变换,加 Karatsuba 交叉项复用 |
| 计算单元 | 面向单一阶段,或通过更多独立单元提高并行度 | 让统一 radix-4 BU 承担多个阶段的相近运算 |
| 存储衔接 | 依赖额外缓冲、阶段间搬运或较复杂的地址调度 | 用交叉写回组织下一阶段所需的数据,并缩短装载等待 |
| 参数配置 | 固定参数可充分专化;通用配置需要额外硬件 | 同时讨论 CTC 和 RTC,并显式承担固定最大位宽与参数存储的成本 |
【Analysis】 这些选择将优化对象扩展到整个乘法过程的运算图和数据驻留方式。因此,比较时既要看蝶形和约减器,也要看阶段之间是否需要额外搬运、中间结果能否复用,以及参数切换怎样影响资源组织。
6.4 代价与适用条件#
【Analysis】 四路分解引入子变换与重组,统一 BU 则增加路径选择、寄存器和控制逻辑。设计是否划算,取决于减少的模乘和复用的资源能否覆盖这些额外成本;第 5 节的并行度比较正体现了这种取舍。
参数配置还需要算法与硬件共同配合:子变换满足第 3 节的单位根条件,模数及中间值落在数据通路宽度内,旋转因子与逆元和模式参数一致,bank 地址与流水线时延对齐。扩展模数时,还要检查 Barrett 稀疏表示所需的移位项、控制位与关键路径是否能由现有电路支持。
这些条件给出了选择配置的实际顺序:先确认参数与运算正确性,再选择 BU 数、存储组织和时钟目标,最后用完整乘法的资源与延迟评价实现。
7. 局限性#
7.1 作者明确提出的局限#
【Paper】 RTC 为不同模数使用固定宽度乘法器,因此小位宽模式仍占用同样的 DSP;参数表和缓冲也增加存储成本。这使可配置设计在面积上需要与专用实现取舍。作者将高效侧信道防护列为后续工作。[1] §V-D、§VI,p.3422
7.2 自己分析得到的局限#
【Paper】 Table I 将 Kyber 的 Barrett 参数 列为 5040;Algorithm 3 定义 ,末尾修正条件写为 while t > q。[1] Algorithm 3、Table I,pp.3415–3416
【Analysis】 结合这些细节与前面的实验、代码对照,后续使用主要有三项工作:
- 补充约减边界测试。 按 计算, 为 5039;目标输出区间为 时,修正逻辑还应覆盖 。这两处适合作为参考模型和约减单元的定向测试用例。
- 分离各项优化的贡献。 论文给出了模乘计数、约减器比较和调度示例,仍缺少在同一器件、同一约束下逐项开关分解、统一 BU 与存储调度的完整消融。补齐这组实验,可以进一步解释完整乘法的收益主要来自哪里。
- 补齐 RTC 的复现工程。 第 4.5 节的代码差异需要在具体工程中解决;随后用参数切换测试、bank 访问检查和布局布线,验证各模式的正确性与时序。
8. 启发与研究思考#
【Analysis】 KHNTT 留下了一个值得继续研究的问题:在模乘次数已经减少之后,怎样让算术资源与数据供给更匹配?
第一种研究假设是:对于短多项式,优化阶段衔接与存储组织,可能比继续增加 BU 更有利于 ATP。 现有 4 BU 与 8 BU 配置可以作为起点。在同一器件、参数和约束下,比较 BU 数与调度策略的组合,记录有效计算周期、等待周期、布局布线后的频率以及原生资源。若调度改进以较少新增资源降低延迟和 ATP,便支持这一判断;若等待占比已经很低、改动也没有改善频率,则应把优化重点转向算术或控制路径。
第二种假设是:ATP 最优的分解深度取决于硬件并行度与存储成本,可能与模乘次数最少的深度不同。 可以选取三种深度均满足单位根条件的 ,在同一硬件预算下比较 ,让各版本完成相同的负循环乘法,记录中间结果数量、访存与布局布线后的资源、延迟。若 始终取得最低 ATP,便说明论文的计数选择在这些配置中也适合硬件;若最优点随并行度变化,就能进一步建立分解深度与存储组织的选择方法。
这两个实验可以把论文中的算法选择推进到可复用的架构设计依据:一个解释算力如何与数据供给匹配,另一个解释分解深度怎样随硬件成本变化。
资料与核验记录
参考资料